Data Science
Pengenalan Data Science, Google Colab, dan Array NumPy
Pelajari dasar ekosistem data science modern menggunakan Python, lingkungan Google Colab tanpa instalasi, serta fondasi komputasi numerik berkecepatan tinggi dengan array NumPy.

Bayangkan sebuah perusahaan e-commerce rintisan mencatat 5 juta transaksi penjualan setiap kuartal. Tim manajemen ingin mengetahui tren penjualan harian, menghitung margin keuntungan bersih setelah dipotong pajak, serta memprediksi kategori produk yang berpotensi kehabisan stok minggu depan. Ketika seorang analis junior mencoba memproses jutaan data tersebut menggunakan perulangan for dan tipe data list bawaan Python di laptop lokalnya, program mendadak macet (freeze), konsumsi memori melonjak tajam, dan eksekusi memakan waktu puluhan menit. Masalah analitis skala industri seperti ini mustahil diselesaikan dengan pendekatan pemrograman standar. Kita membutuhkan alur kerja data science yang terstandarisasi, lingkungan komputasi awan yang fleksibel, dan struktur data berkinerja tinggi yang dirancang khusus untuk kalkulasi numerik skala masif: NumPy.
Yang akan dipelajari
Dalam artikel pembuka ini, Anda akan mempelajari fondasi praktis data science modern:
- Memahami alur kerja komprehensif data science mulai dari pengumpulan data mentah hingga pemodelan analitis.
- Mengoperasikan lingkungan interaktif Google Colab tanpa perlu instalasi rumit di komputer lokal.
- Membedakan kelemahan struktur data
listPython dibandingkan keunggulan efisiensi komputasinumpy.ndarray. - Membuat array 1 dimensi (vektor) dan 2 dimensi (matriks) menggunakan pustaka NumPy.
- Memeriksa atribut struktural array seperti ukuran dimensi (
ndim), bentuk matriks (shape), dan tipe data elemen (dtype). - Memanfaatkan fungsi generator array otomatis seperti
np.zeros(),np.ones(),np.arange(), dannp.linspace().
Mengapa Data Science Memerlukan Ekosistem Khusus?
Data science bukan sekadar menulis skrip Python biasa, melainkan siklus berulang (iterative lifecycle) untuk mengubah sekumpulan data mentah menjadi wawasan bisnis atau keputusan strategis. Siklus standar industri biasanya mencakup tahapan berikut:
- Perumusan Masalah (Problem Formulation): Menentukan metrik keberhasilan bisnis (misal: menurunkan churn pelanggan atau mempercepat perkiraan stok).
- Pengumpulan & Ekstraksi Data (Data Ingestion): Menarik data dari basis data SQL, sensor IoT, log server, atau API publik.
- Pembersihan & Transformasi (Data Cleaning): Mengatasi nilai kosong, duplikasi, dan format tanggal yang inkonsisten.
- Analisis Eksploratif Data (EDA): Menemukan pola distribusi, outlier, dan korelasi antar variabel melalui statistik deskriptif dan visualisasi.
- Pemodelan Prediktif / Machine Learning: Melatih algoritma machine learning untuk memprediksi nilai masa depan atau mengklasifikasikan kategori.
- Interpretasi & Komunikasi: Menyajikan temuan dalam bentuk laporan atau dasbor interaktif bagi para pemangku kepentingan (stakeholders).
Untuk menjalankan tahapan tersebut secara teratur dan dapat direproduksi (reproducible), komunitas data global beralih ke format Jupyter Notebook dan pustaka ilmiah berbasis komputasi C yang teroptimasi.
Berkenalan dengan Google Colab
Alih-alih menginstal Python, Conda, Visual Studio Code, dan puluhan pustaka (libraries) di sistem operasi lokal Anda, Google Colaboratory (disingkat Google Colab) menyediakan lingkungan Jupyter Notebook berbasis cloud yang berjalan langsung di peramban web (browser).
Keuntungan utama menggunakan Google Colab:
- Nol Instalasi: Anda hanya memerlukan akun Google dan koneksi internet. Pustaka populer seperti NumPy, Pandas, Matplotlib, dan Scikit-Learn sudah terpasang secara bawaan (pre-installed).
- Akses Komputasi Gratis: Colab menyediakan alokasi RAM gratis (~12 GB) serta akses akselerator perangkat keras GPU dan TPU untuk komputasi berat.
- Berbagi Mudah: Dokumen notebook tersimpan di Google Drive dan dapat dibagikan kepada rekan tim layaknya dokumen Google Docs.
Cara memulai di Google Colab:
- Buka situs
colab.research.google.compada peramban Anda. - Klik tombol New Notebook (Notebook Baru).
- Pada sel kode pertama, ketik perintah Python dan tekan kombinasi tombol
Shift + Enteruntuk mengeksekusi sel tersebut.
List Python vs ndarray NumPy: Mengapa Kita Butuh NumPy?
Di Python dasar, kita menyimpan sekumpulan nilai dalam tipe data list. Namun, list dirancang sebagai wadah heterogen yang fleksibel: satu list dapat menampung integer, string, boolean, bahkan objek lain sekaligus. Fleksibilitas ini menuntut biaya (overhead) memori yang sangat mahal karena setiap elemen disimpan sebagai pointer ke objek Python terpisah.
NumPy (Numerical Python) mengatasi kelemahan ini dengan memperkenalkan tipe data ndarray (N-dimensional array). Karakteristik kunci ndarray:
- Homogen: Semua elemen di dalam array harus memiliki tipe data yang sama (misalnya semuanya
float64atauint32). - Memori Berdampingan (Contiguous Memory): Elemen disimpan berdampingan secara fisik di dalam blok memori komputer, memungkinkan CPU dan prosesor modern melakukan komputasi paralel melalui instruksi SIMD (Single Instruction, Multiple Data).
- Kode C Terkompilasi: Operasi matematika NumPy dieksekusi oleh mesin kompilasi C/Fortran berkecepatan tinggi tanpa hambatan interpretasi baris-demi-baris Python.
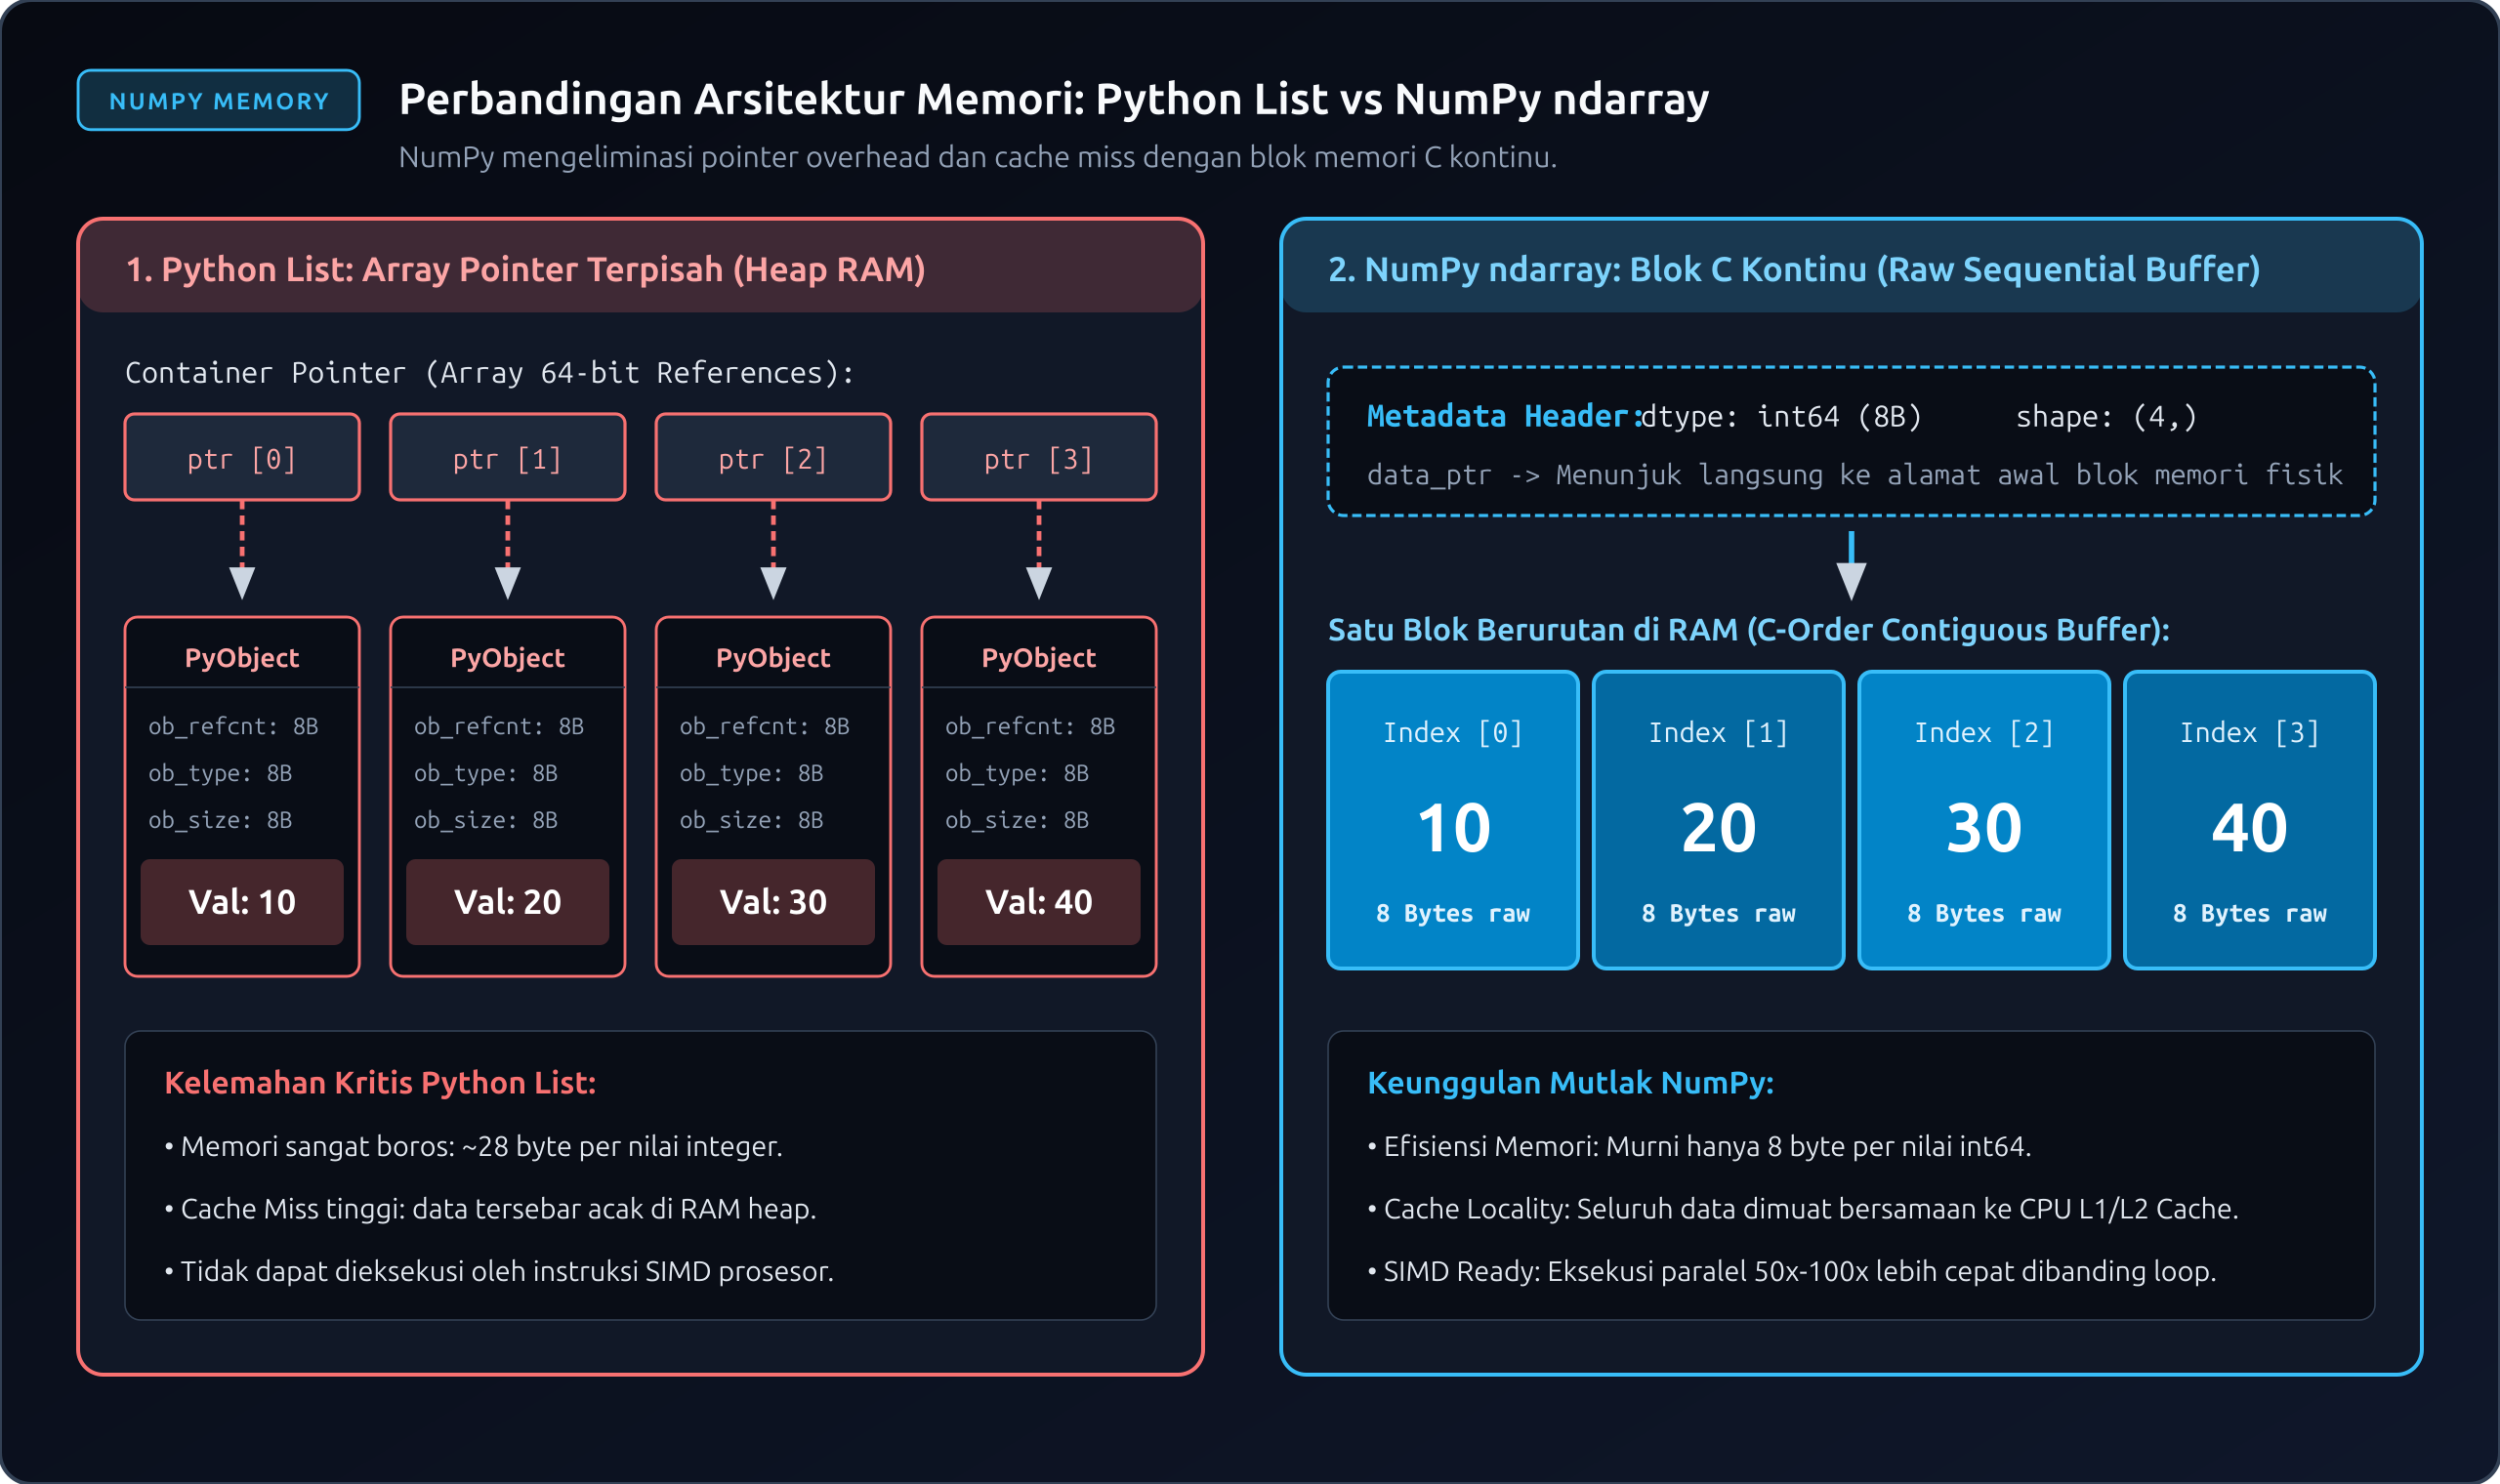
Mari kita buktikan perbedaan efisiensi ini secara langsung melalui simulasi perkalian elemen:
import numpy as np
import time

# Ukuran dataset: 1 juta elemen
banyak_elemen = 1_000_000

# 1. Menggunakan List Python bawaan
list_angka = list(range(banyak_elemen))
waktu_mulai = time.time()
hasil_list = [x * 2 for x in list_angka]
durasi_list = time.time() - waktu_mulai

# 2. Menggunakan ndarray NumPy
array_angka = np.arange(banyak_elemen)
waktu_mulai = time.time()
hasil_array = array_angka * 2
durasi_numpy = time.time() - waktu_mulai

print(f"Waktu eksekusi List Python : {durasi_list:.4f} detik")
print(f"Waktu eksekusi NumPy Array : {durasi_numpy:.4f} detik")
print(f"NumPy lebih cepat sekitar {durasi_list / durasi_numpy:.1f} kali lipat!")

# Output di Google Colab:
# Waktu eksekusi List Python : 0.0820 detik
# Waktu eksekusi NumPy Array : 0.0019 detik
# NumPy lebih cepat sekitar 43.2 kali lipat!
Perbedaan kecepatan puluhan kali lipat ini akan menjadi penentu krusial saat Anda menganalisis jutaan baris data atau melatih model kecerdasan buatan.
Membuat Array NumPy 1D dan 2D
Untuk menggunakan NumPy, kita mengimpor pustaka ini dengan alias konvensional np:
import numpy as np
1. Array Satu Dimensi (Vektor)
Array 1D mewakili sekumpulan data berderet tunggal, serupa dengan data satu variabel (misal: daftar temperatur harian).
# Membuat array 1D dari list angka
temperatur_kota = np.array([28.5, 29.2, 31.0, 30.4, 27.8])

print("Tipe objek:", type(temperatur_kota))
print("Isi array:", temperatur_kota)

# Output:
# Tipe objek: <class 'numpy.ndarray'>
# Isi array: [28.5 29.2 31.  30.4 27.8]
2. Array Dua Dimensi (Matriks)
Array 2D mewakili data tabular yang tersusun atas baris (rows) dan kolom (columns), serupa dengan tabel spreadsheet atau citra monokrom.
# Membuat matriks 2D (3 baris x 4 kolom) nilai penjualan kuartalan
penjualan_toko = np.array([
    [120, 145, 130, 160],  # Toko Cabang A
    [95,  110, 105, 130],  # Toko Cabang B
    [210, 230, 240, 280]   # Toko Cabang C
])

print("Matriks penjualan toko:")
print(penjualan_toko)

# Output:
# Matriks penjualan toko:
# [[120 145 130 160]
#  [ 95 110 105 130]
#  [210 230 240 280]]
Memeriksa Atribut Struktural Array
Sebelum memproses data, analis perlu mengetahui arsitektur array yang sedang dihadapi. Tiga atribut paling penting pada objek ndarray adalah:
.ndim: Menunjukkan banyaknya dimensi (sumbu/axis). Nilai1untuk vektor,2untuk matriks,3untuk tensor 3D (seperti gambar RGB)..shape: Tuple yang mendeskripsikan panjang elemen di setiap dimensi. Misalnya(3, 4)berarti memiliki 3 baris dan 4 kolom..dtype: Tipe data internal elemen (misalnyaint64,int32,float64, ataubool).
data_sensor = np.array([
    [10.5, 12.1, 11.8],
    [14.2, 13.9, 15.0]
])

print("Jumlah dimensi (ndim) :", data_sensor.ndim)
print("Bentuk matriks (shape):", data_sensor.shape)
print("Tipe data elemen (dtype):", data_sensor.dtype)
print("Total elemen (size)   :", data_sensor.size)

# Output:
# Jumlah dimensi (ndim) : 2
# Bentuk matriks (shape): (2, 3)
# Tipe data elemen (dtype): float64
# Total elemen (size)   : 6
Catatan Konseptual: Jika Anda memasukkan data campuran (misal integer dan string ke dalam satu array), NumPy secara otomatis melakukan pemaksaan tipe (type coercion) ke representasi paling umum (biasanya string
U...), sehingga operasi matematika numerik tidak lagi dapat dijalankan secara langsung.
Generator Array Otomatis
Sering kali kita perlu menginisialisasi array dengan nilai awal tertentu tanpa harus mengetik nilainya satu per satu secara manual. NumPy menyediakan serangkaian fungsi generator:
1. np.zeros() dan np.ones()
Digunakan untuk membuat matriks yang seluruh isinya bernilai nol (0) atau satu (1). Sangat umum digunakan untuk inisialisasi bobot model atau matriks penampung (placeholder).
# Matriks nol ukuran 2 baris x 4 kolom
matriks_nol = np.zeros(shape=(2, 4), dtype=int)
print("Matriks Nol:\n", matriks_nol)

# Matriks satu ukuran 3 baris x 3 kolom (matriks persegi)
matriks_satu = np.ones(shape=(3, 3), dtype=float)
print("\nMatriks Satu:\n", matriks_satu)

# Output:
# Matriks Nol:
#  [[0 0 0 0]
#  [0 0 0 0]]
#
# Matriks Satu:
#  [[1. 1. 1.]
#  [1. 1. 1.]
#  [1. 1. 1.]]
2. np.arange()
Mirip dengan fungsi range() bawaan Python, tetapi langsung menghasilkan objek ndarray dengan interval nilai tertentu.
Sintaks: np.arange(start, stop, step)
# Bilangan genap dari 0 hingga sebelum 20 dengan loncatan 2
bilangan_genap = np.arange(0, 20, 2)
print("Array arange:", bilangan_genap)

# Output:
# Array arange: [ 0  2  4  6  8 10 12 14 16 18]
3. np.linspace()
Singkatan dari linear spacing. Berbeda dengan arange yang menentukan besarnya langkah loncatan (step), linspace menentukan banyaknya titik sampel yang ingin dibagi rata di antara batas awal dan batas akhir (inklusif).
Sintaks: np.linspace(start, stop, num)
# Bagi rentang 0 sampai 1 menjadi tepat 5 titik berjarak seragam
titik_sampel = np.linspace(0.0, 1.0, num=5)
print("Array linspace:", titik_sampel)

# Output:
# Array linspace: [0.   0.25 0.5  0.75 1.  ]
np.linspace() sangat esensial saat membuat sumbu x pada grafik visualisasi fungsi kontinu seperti kurva sinus atau distribusi normal.
Coba sendiri
Jalankan eksperimen kode interaktif berikut di Google Colab Anda:
- Buat notebook baru di Google Colab.
- Buat matriks 2D berukuran 4 baris dan 3 kolom yang berisi angka acak atau berurutan dari 1 sampai 12 menggunakan kombinasi
np.arange(1, 13).reshape(4, 3). - Cetak nilai atribut
.shape,.ndim, dan.dtypedari matriks tersebut. - Buat array 1D berisi 11 titik pembagian rata antara suhu 36.0 derajat Celcius hingga 41.0 derajat Celcius menggunakan
np.linspace().
# Coba jalankan kode ini di Colab Anda:
import numpy as np

matriks_eksperimen = np.arange(1, 13).reshape(4, 3)
print("Matriks:\n", matriks_eksperimen)
print("Dimensi:", matriks_eksperimen.ndim, "| Bentuk:", matriks_eksperimen.shape)

rentang_suhu = np.linspace(36.0, 41.0, 11)
print("\nRentang suhu:", rentang_suhu)
Kesalahan yang sering terjadi
Berikut adalah ringkasan kekeliruan umum yang sering dialami oleh pemula saat pertama kali bekerja dengan NumPy beserta cara mengatasinya:
| Kesalahan Pemula | Gejala / Pesan Kesalahan | Penyebab Utama | Solusi yang Tepat |
|---|---|---|---|
| Lupa membungkus list bersarang dengan tanda kurung | TypeError: Field data must be specified using a list... |
Menulis np.array(1, 2, 3) tanpa tanda kurung siku pembungkus list. |
Masukkan elemen dalam kurung siku tunggal: np.array([1, 2, 3]). |
Melewatkan parameter bentuk tuple pada np.zeros() |
TypeError: data type not understood |
Menulis np.zeros(3, 4) tanpa tanda kurung tuple penanda dimensi matriks. |
Berikan tuple untuk dimensi multi-axis: np.zeros((3, 4)) atau gunakan parameter eksplisit shape=(3, 4). |
Mengharapkan np.arange() menyertakan angka akhir (stop) |
Angka batas akhir tidak muncul di dalam array | Parameter stop pada arange bersifat eksklusif (tidak diikutsertakan). |
Gunakan batas akhir yang lebih besar sesuai step, atau beralih ke np.linspace() jika ingin batas akhir pasti diikutsertakan. |
| Elemen bercampur tipe data string dan angka | Operasi matematika gagal (U32 dtype) |
Memasukkan elemen string ke dalam array numerik tanpa disadari. | Pastikan seluruh elemen homogen numerik, atau bersihkan teks sebelum dimasukkan ke array. |
Kaitannya dengan Praktik Industri / AI: Di era kecerdasan buatan modern, pustaka Deep Learning kelas industri seperti TensorFlow dan PyTorch dibangun dengan konsep desain API yang mengadopsi penuh standar
ndarraymilik NumPy. Struktur Tensor di PyTorch dan TensorFlow pada hakikatnya adalah generalisasi dari array multidimensi NumPy yang dipindahkan ke memori kartu grafis (GPU/TPU) untuk perhitungan gradien otomatis. Memahami konsepshape,dtype, dan dimensi di NumPy adalah fondasi wajib sebelum Anda memproses gambar komputer (citra RGB sebagai matriks 3D) atau bobot jaringan saraf tiruan (neural network).
Latihan
Ujilah pemahaman Anda dengan mengerjakan 3 soal analisis mandiri berikut:
- Soal 1: Sebuah laboratorium iklim mengukur curah hujan harian (dalam milimeter) selama 7 hari berturut-turut:
12.5,0.0,5.2,18.0,22.4,0.0,8.7. Buatlah array NumPy 1D dari data tersebut, lalu cetak tipe datanya (dtype) serta total elemen yang tersimpan di dalamnya. - Soal 2: Buatlah sebuah matriks 2D berukuran 3 baris dan 5 kolom yang seluruh elemennya bernilai
1.0(tipe data float). Kemudian ubah nilai seluruh elemen pada baris pertama menjadi angka0.0menggunakan indexing matriks, lalu tampilkan hasilnya. - Soal 3: Sebuah sensor getaran frekuensi merekam data sampling gelombang dari frekuensi 100 Hz hingga 500 Hz. Buatlah array NumPy yang membagi rentang frekuensi tersebut menjadi tepat 9 titik sampel yang berjarak sama menggunakan fungsi yang tepat. Tampilkan array yang dihasilkan.
Kunci jawaban dan pembahasan
Solusi Soal 1
import numpy as np

# Membuat array curah hujan harian
curah_hujan = np.array([12.5, 0.0, 5.2, 18.0, 22.4, 0.0, 8.7])

print("Array curah hujan:", curah_hujan)
print("Tipe data elemen :", curah_hujan.dtype)
print("Total elemen data:", curah_hujan.size)

# Output:
# Array curah hujan: [12.5  0.   5.2 18.  22.4  0.   8.7]
# Tipe data elemen : float64
# Total elemen data: 7
Pembahasan: Karena seluruh angka mengandung desimal atau dicampur dengan float (0.0), NumPy secara otomatis menetapkan float64 sebagai tipe data array. Atribut .size mengembalikan jumlah total elemen dalam array 1D tersebut, yaitu 7.
Solusi Soal 2
import numpy as np

# Membuat matriks 3x5 dengan nilai awal 1.0
matriks_sinyal = np.ones((3, 5), dtype=float)

# Mengubah baris pertama (indeks 0) menjadi 0.0
matriks_sinyal[0, :] = 0.0

print("Matriks setelah modifikasi baris pertama:")
print(matriks_sinyal)

# Output:
# Matriks setelah modifikasi baris pertama:
# [[0. 0. 0. 0. 0.]
#  [1. 1. 1. 1. 1.]
#  [1. 1. 1. 1. 1.]]
Pembahasan: Fungsi np.ones((3, 5)) membuat matriks berukuran 3 baris dan 5 kolom. Notasi [0, :] berarti "pilih baris indeks ke-0 dan seluruh kolom (:)", lalu memberikan nilai baru 0.0 secara langsung ke seluruh elemen di baris tersebut.
Solusi Soal 3
import numpy as np

# Membagi rentang frekuensi 100 Hz hingga 500 Hz menjadi 9 titik
frekuensi_sampel = np.linspace(100.0, 500.0, num=9)

print("Titik frekuensi sampling:")
print(frekuensi_sampel)

# Output:
# Titik frekuensi sampling:
# [100. 150. 200. 250. 300. 350. 400. 450. 500.]
Pembahasan: Fungsi np.linspace(start, stop, num) adalah pilihan paling tepat untuk membagi rentang kontinu menjadi jumlah titik tertentu yang berjarak merata. Dengan menentukan num=9, NumPy secara matematis menghitung interval jarak antar titik, yaitu Hz per interval.


Discussion (0)
We store your optional name, your comment, and technical hashes (not your raw IP address) to prevent spam. A functional cookie lets you edit or delete your own comments from this browser. To request deletion, use the contact page.
No comments yet. Start the discussion.