Data Science
Manipulasi Array: Indexing, Slicing, dan Vektorisasi
Kuasai teknik indexing, slicing matriks, aturan broadcasting, serta operasi vektorisasi dan agregasi numerik NumPy untuk pengolahan data berkecepatan tinggi tanpa loop.

Dalam dunia nyata, data mentah jarang sekali langsung siap pakai dalam format yang diinginkan. Bayangkan Anda adalah data analyst di sebuah platform fintech yang memproses matriks transaksi harian: baris mewakili pengguna dan kolom mewakili pengeluaran di berbagai kategori belanja. Anda diminta untuk mengambil data transaksi pengguna tertentu, mendeteksi nilai-nilai pengeluaran yang mencurigakan (anomali) di atas batas toleransi, memberikan penyesuaian biaya admin serentak untuk semua pengguna, dan menghitung ringkasan pengeluaran per kategori. Jika Anda terbiasa menulis perulangan for bersarang (nested loops) dengan kondisi if berganda layaknya pemrogram Python konvensional, skrip Anda akan menjadi sangat lambat dan sulit dibaca ketika data membesar hingga ratusan ribu baris. Kunci utama untuk membuka performa komputasi data science tingkat lanjut adalah menguasai pemotongan data (slicing), operasi vektorisasi (vectorization), mekanisme broadcasting, dan pengindeksan boolean di NumPy.
Yang akan dipelajari
Dalam artikel ini, Anda akan mempelajari keterampilan inti manipulasi array NumPy:
- Mengambil elemen, baris spesifik, dan blok submatriks menggunakan teknik indexing serta slicing multi-dimensi.
- Memahami konsep vektorisasi untuk melakukan kalkulasi matematis instan tanpa perulangan manual.
- Menguasai aturan broadcasting ketika mengoperasikan dua array dengan bentuk (shape) yang berbeda.
- Menerapkan boolean indexing untuk menyaring data yang memenuhi kondisi logika tertentu.
- Melakukan agregasi statistik berkinerja tinggi (
sum,mean,std,min,max) dengan memahami pemetaan sumbu (axis 0 vs axis 1).
Indexing dan Slicing Matriks Baris-Kolom
Berbeda dengan list Python bertingkat yang mengharuskan pemanggilan berulang seperti matriks[baris][kolom], NumPy menyediakan sintaks terpadu yang jauh lebih ekspresif dan cepat: array[indeks_baris, indeks_kolom].
Sintaks pemotongan (slicing) mengikuti pola standar: awal:akhir:langkah. Batas akhir selalu bersifat eksklusif.
Mari kita simulasikan tabel nilai ujian 4 siswa (baris) pada 3 mata pelajaran (kolom: Matematika, Fisika, Kimia):
import numpy as np

# Matriks 4 baris x 3 kolom (nilai siswa)
nilai_siswa = np.array([
    [75, 82, 90],  # Siswa 0 (Andi)
    [88, 65, 78],  # Siswa 1 (Budi)
    [92, 95, 89],  # Siswa 2 (Citra)
    [60, 70, 68]   # Siswa 3 (Dewi)
])

# 1. Mengambil satu nilai spesifik: nilai Fisika Budi (baris indeks 1, kolom indeks 1)
nilai_fisika_budi = nilai_siswa[1, 1]
print("Nilai Fisika Budi:", nilai_fisika_budi)

# 2. Mengambil seluruh nilai satu siswa (satu baris utuh)
nilai_citra = nilai_siswa[2, :]
print("Nilai seluruh mapel Citra:", nilai_citra)

# 3. Mengambil nilai satu mata pelajaran untuk seluruh siswa (satu kolom utuh: Matematika)
nilai_matematika = nilai_siswa[:, 0]
print("Nilai Matematika seluruh siswa:", nilai_matematika)

# 4. Slicing submatriks: nilai 2 siswa pertama untuk 2 mapel pertama
sub_matriks = nilai_siswa[0:2, 0:2]
print("\nSubmatriks 2x2 siswa pertama:\n", sub_matriks)

# Output:
# Nilai Fisika Budi: 65
# Nilai seluruh mapel Citra: [92 95 89]
# Nilai Matematika seluruh siswa: [75 88 92 60]
#
# Submatriks 2x2 siswa pertama:
# [[75 82]
#  [88 65]]
Tanda titik dua tunggal : berarti memilih seluruh elemen pada sumbu tersebut. Trik ini sangat praktis ketika memisahkan fitur variabel independen () dan target () dalam machine learning kelak.
Vektorisasi: Melakukan Komputasi Tanpa Looping
Vektorisasi adalah paradigma pemrograman di mana operasi matematika diterapkan langsung pada keseluruhan array sekaligus di tingkat kode mesin C yang mendasarinya, bukan dengan mengulang setiap elemen di tingkat interpreter Python.
Perhatikan perbandingan berikut saat kita ingin menambahkan bonus 5 poin untuk semua nilai siswa:
# Cara lambat (tanpa vektorisasi / imperative loop)
# for i in range(len(nilai_siswa)):
#     for j in range(len(nilai_siswa[0])):
#         nilai_siswa[i, j] += 5

# Cara modern dengan NumPy (Vektorisasi)
nilai_bonus = nilai_siswa + 5
print("Nilai setelah ditambah bonus 5 poin:")
print(nilai_bonus)

# Output:
# Nilai setelah ditambah bonus 5 poin:
# [[ 80  87  95]
#  [ 93  70  83]
#  [ 97 100  94]
#  [ 65  75  73]]
Operasi aritmatika standar seperti penjumlahan (+), pengurangan (-), perkalian elemen demi elemen (*), pembagian (/), dan pemangkatan (**) secara otomatis tervektorisasi di NumPy.
Mekanisme Broadcasting
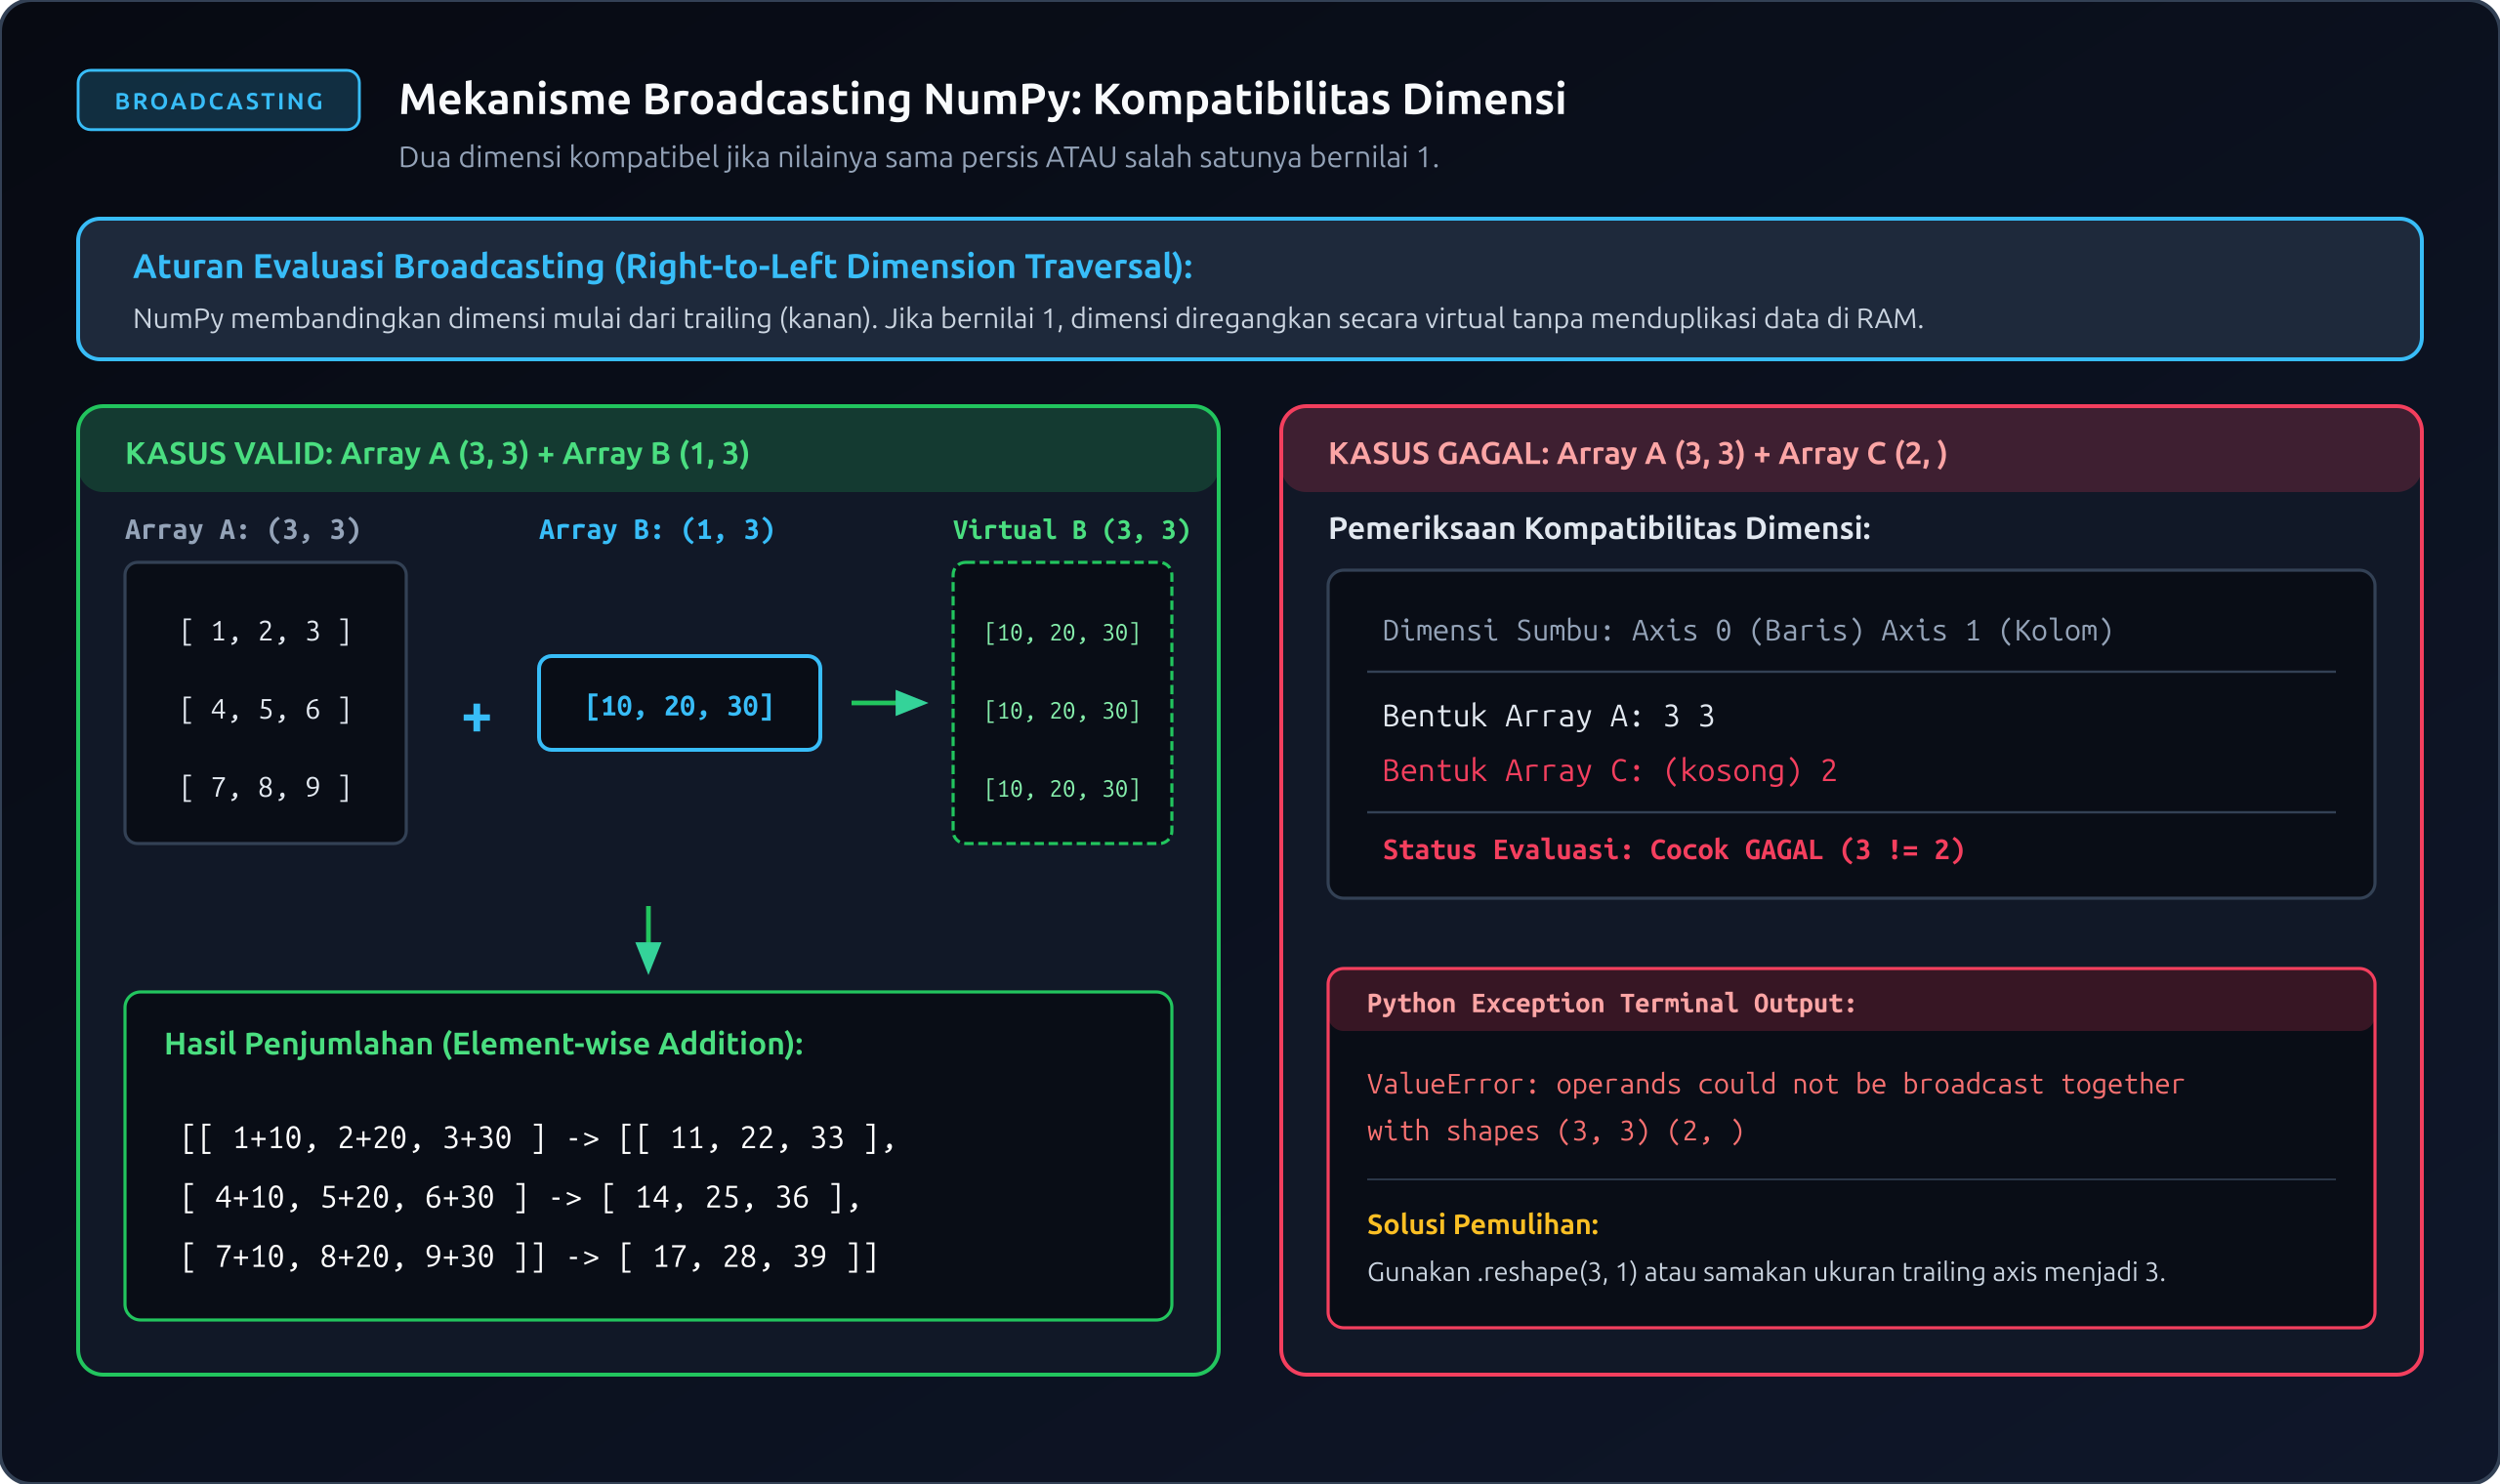
Bagaimana jika kita ingin menjumlahkan dua array yang dimensinya tidak persis sama? Di sinilah konsep broadcasting bekerja. Broadcasting adalah aturan cerdas NumPy untuk memperluas dimensi array yang lebih kecil secara virtual agar cocok dengan dimensi array yang lebih besar tanpa membuat salinan data baru di memori.
Aturan Kompatibilitas Broadcasting
Dua array dapat dibroadcast jika untuk setiap dimensi (dibandingkan dari dimensi paling kanan ke kiri):
- Ukuran dimensinya bernilai sama, ATAU
- Salah satu array memiliki ukuran dimensi bernilai
1.
Contoh kasus: Setiap mata pelajaran memiliki bobot ujian berbeda yang harus dikalikan ke setiap kolom:
- Matriks nilai: ukuran
(4, 3)(4 siswa, 3 mapel) - Vektor bobot: ukuran
(3,)(3 mapel)
bobot_mapel = np.array([0.4, 0.3, 0.3])

# Perkalian matriks (4, 3) dengan vektor (3,)
# Dimensi bobot (3,) otomatis diperluas secara virtual menjadi (4, 3)
nilai_terbobot = nilai_siswa * bobot_mapel

print("Nilai setelah dikalikan bobot mapel:")
print(np.round(nilai_terbobot, 2))

# Output:
# Nilai setelah dikalikan bobot mapel:
# [[30.  24.6 27. ]
#  [35.2 19.5 23.4]
#  [36.8 28.5 26.7]
#  [24.  21.  20.4]]
Jika dimensi kedua array tidak kompatibel (misalnya matriks (4, 3) dioperasikan dengan array panjang 4 tanpa penyesuaian bentuk axis), NumPy akan memicu galat ValueError: operands could not be broadcast together.
Boolean Indexing: Menyaring Data Secara Kondisional
Boolean indexing memungkinkan kita menyaring elemen array berdasarkan kriteria logika tertentu tanpa perlu menyusun blok if-else.
Langkahnya terdiri dari dua fase:
- Mengevaluasi kondisi logika terhadap array untuk menghasilkan mask boolean (array
True/False). - Menggunakan mask boolean tersebut sebagai indeks ke dalam array asli untuk mengambil hanya nilai yang bertanda
True.
suhu_ruang = np.array([24.5, 27.8, 31.2, 29.0, 33.5, 26.1, 35.0])

# 1. Membuat boolean mask: suhu di atas batas aman (>= 30.0)
kondisi_panas = suhu_ruang >= 30.0
print("Mask Boolean:", kondisi_panas)

# 2. Mengambil elemen yang memenuhi kondisi
suhu_kritis = suhu_ruang[kondisi_panas]
print("Nilai suhu kritis yang terdeteksi:", suhu_kritis)

# 3. Menggabungkan kondisi logika ganda (gunakan operator bitwise '&' untuk AND, '|' untuk OR)
# Temukan suhu antara 25.0 dan 30.0
kondisi_ideal = (suhu_ruang >= 25.0) & (suhu_ruang <= 30.0)
print("Suhu dalam rentang ideal (25-30):", suhu_ruang[kondisi_ideal])

# Output:
# Mask Boolean: [False False  True False  True False  True]
# Nilai suhu kritis yang terdeteksi: [31.2 33.5 35. ]
# Suhu dalam rentang ideal (25-30): [27.8 29.  26.1]
Peringatan Penting: Saat menyaring array dengan kondisi ganda di NumPy, Anda wajib menggunakan operator bitwise
&(dan) serta|(atau), serta membungkus setiap kondisi dalam tanda kurung(). Jangan gunakan kata kunciandatauorPython biasa!
Agregasi Numerik: Menghitung Statistik Cepat
NumPy menyediakan serangkaian fungsi agregasi berkecepatan tinggi seperti np.sum(), np.mean(), np.std(), np.min(), dan np.max().
Pada matriks 2 dimensi, kita dapat mengarahkan kalkulasi statistik menggunakan parameter axis:
axis=0: Berjalan menyusuri baris ke bawah (menghitung statistik per kolom).axis=1: Berjalan menyusuri kolom ke samping (menghitung statistik per baris).- Tanpa parameter axis: Menghitung ringkasan dari seluruh elemen matriks.
data_penjualan = np.array([
    [100, 150, 120],  # Hari Senin (Cabang A, B, C)
    [130, 140, 110],  # Hari Selasa
    [200, 210, 190],  # Hari Rabu
    [180, 170, 160]   # Hari Kamis
])

# 1. Total penjualan seluruh cabang di semua hari
total_omset = np.sum(data_penjualan)
print("Total omset keseluruhan:", total_omset)

# 2. Total penjualan per cabang (menyusuri baris -> axis=0)
omset_per_cabang = np.sum(data_penjualan, axis=0)
print("Total omset Cabang [A, B, C]:", omset_per_cabang)

# 3. Rata-rata penjualan per hari (menyusuri kolom -> axis=1)
rata_harian = np.mean(data_penjualan, axis=1)
print("Rata-rata penjualan per hari [Senin s.d. Kamis]:", rata_harian)

# 4. Standar deviasi penjualan untuk mengukur fluktuasi
standar_deviasi = np.std(data_penjualan)
print(f"Standar deviasi penjualan: {standar_deviasi:.2f}")

# Output:
# Total omset keseluruhan: 1750
# Total omset Cabang [A, B, C]: [610 670 470]
# Rata-rata penjualan per hari [Senin s.d. Kamis]: [123.33333333 126.66666667 200.         170.        ]
# Standar deviasi penjualan: 34.33
Coba sendiri
Jalankan eksperimen manipulasi array berikut di Google Colab:
- Buat matriks acak bilangan bulat berukuran 5 baris dan 4 kolom dengan rentang nilai 50 sampai 100 menggunakan
np.random.randint(50, 101, size=(5, 4)). - Potong matriks tersebut untuk mengambil baris ke-1 hingga ke-3 pada kolom ke-2 dan ke-3 saja.
- Carilah seluruh angka pada matriks yang nilainya lebih besar dari 85 menggunakan boolean indexing.
- Hitung nilai rata-rata per kolom (
axis=0) dan nilai maksimum per baris (axis=1).
# Coba jalankan di sel Google Colab:
import numpy as np

# Menyetel seed agar hasil konsisten
np.random.seed(42)
matriks_nilai = np.random.randint(50, 101, size=(5, 4))
print("Matriks Asli:\n", matriks_nilai)

# Irisan submatriks
print("\nIrisan Baris 1-3, Kolom 2-3:\n", matriks_nilai[1:4, 2:4])

# Filter nilai > 85
print("\nElemen di atas 85:", matriks_nilai[matriks_nilai > 85])

# Rata-rata per kolom & Max per baris
print("\nRata-rata per kolom:", np.mean(matriks_nilai, axis=0))
print("Maksimum per baris   :", np.max(matriks_nilai, axis=1))
Kesalahan yang sering terjadi
Tabel berikut merangkum kesalahan paling lazim saat memanipulasi array NumPy:
| Kesalahan Pemula | Gejala / Pesan Kesalahan | Penyebab Utama | Solusi yang Tepat |
|---|---|---|---|
Menggunakan operator and / or pada array |
ValueError: The truth value of an array with more than one element is ambiguous... |
Menggunakan kata kunci logika skalar bawaan Python untuk mengevaluasi array. | Gunakan operator logika bitwise NumPy: & untuk AND, | untuk OR, dan ~ untuk NOT. |
| Lupa tanda kurung pada kondisi ganda | TypeError: ufunc 'bitwise_and' not supported for input types... |
Prioritas operator bitwise lebih tinggi daripada operator perbandingan (<, >). |
Selalu kurung setiap perbandingan logika: (arr > 10) & (arr < 50). |
Tertukar arah axis=0 dan axis=1 |
Hasil ringkasan statistik terbalik (jumlah baris vs kolom) | Menghafal axis secara terbalik. | Ingat: axis=0 runtuh vertikal (ke bawah menghasilkan per kolom), axis=1 runtuh horizontal (ke samping menghasilkan per baris). |
| Ketidakcocokan dimensi broadcasting | ValueError: operands could not be broadcast together with shapes (4,3) (4,) |
Mencoba membroadcast array 1D ke kolom matriks tanpa menyesuaikan bentuknya menjadi matriks tegak (4, 1). |
Ubah bentuk array dengan .reshape(-1, 1) atau gunakan [:, np.newaxis]. |
Kaitannya dengan Praktik Industri / AI: Dalam bidang Computer Vision (pengolahan citra) dan Deep Learning, seluruh gambar digital direpresentasikan sebagai array 3 dimensi:
(tinggi, lebar, 3 saluran warna RGB). Operasi pemotongan gambar (image cropping) tidak lain adalah operasi slicing NumPy seperticitra[y_awal:y_akhir, x_awal:x_akhir, :]. Sementara itu, teknik normalisasi pixel citra dari rentang 0–255 ke rentang 0.0–1.0 dilakukan dengan vektorisasi satu baris:citra_normal = citra / 255.0. Tanpa vektorisasi dan broadcasting, melatih model pengenalan wajah atau deteksi objek akan membutuhkan waktu berminggu-minggu lebih lama.
Latihan
Ujilah kecakapan Anda dengan 3 skenario analitis berikut:
- Soal 1: Sebuah matriks berukuran menyimpan nilai tarif parkir di 3 zona selama 3 shift kerja:
tarif = np.array([ [15000, 20000, 25000], [18000, 22000, 28000], [12000, 16000, 21000] ]) - Soal 2: Diberikan array kecepatan kendaraan (dalam km/jam):
kecepatan = np.array([45, 62, 85, 110, 58, 92, 125, 74, 40])Filter dan tampilkan hanya kendaraan yang melanggar batas kecepatan (kecepatan km/jam). Kemudian hitung berapa persentase kendaraan yang melanggar aturan tersebut. - Soal 3: Diberikan matriks konsumsi daya listrik 4 gedung perkantoran selama 5 hari kerja (ukuran ). Carilah gedung mana (indeks baris) yang memiliki rata-rata konsumsi daya harian tertinggi, dan gedung mana yang paling hemat.
Kunci jawaban dan pembahasan
Solusi Soal 1
import numpy as np

tarif = np.array([
    [15000, 20000, 25000],
    [18000, 22000, 28000],
    [12000, 16000, 21000]
])

# Memotong baris 0 sampai 1 (indeks 0:2) dan kolom 1 sampai 2 (indeks 1:3)
sub_tarif = tarif[0:2, 1:3]

print("Submatriks tarif shift 1-2 untuk zona 2-3:")
print(sub_tarif)

# Output:
# Submatriks tarif shift 1-2 untuk zona 2-3:
# [[20000 25000]
#  [22000 28000]]
Pembahasan: Indeks 0:2 memilih baris ke-0 dan ke-1 (angka 2 bersifat batas eksklusif). Indeks kolom 1:3 memilih kolom indeks 1 dan 2. Hasil pemotongan menghasilkan matriks baru berdimensi .
Solusi Soal 2
import numpy as np

kecepatan = np.array([45, 62, 85, 110, 58, 92, 125, 74, 40])

# 1. Boolean indexing untuk menemukan pelanggaran
pelanggar = kecepatan[kecepatan > 80]
print("Kecepatan kendaraan pelanggar (> 80 km/jam):", pelanggar)

# 2. Menghitung persentase
total_kendaraan = kecepatan.size
jumlah_pelanggar = pelanggar.size
persentase = (jumlah_pelanggar / total_kendaraan) * 100

print(f"Jumlah pelanggar : {jumlah_pelanggar} dari {total_kendaraan} kendaraan")
print(f"Persentase       : {persentase:.1f}%")

# Output:
# Kecepatan kendaraan pelanggar (> 80 km/jam): [ 85 110  92 125]
# Jumlah pelanggar : 4 dari 9 kendaraan
# Persentase       : 44.4%
Pembahasan: Kondisi kecepatan > 80 menghasilkan mask array boolean [False, False, True, True, False, True, True, False, False]. Memasukkan mask tersebut ke dalam kecepatan[...] mengekstrak tepat 4 elemen yang melebihi batas kecepatan.
Solusi Soal 3
import numpy as np

# Matriks konsumsi daya (4 gedung x 5 hari kerja)
daya_gedung = np.array([
    [320, 310, 315, 330, 325],  # Gedung 0
    [450, 470, 460, 480, 465],  # Gedung 1
    [210, 205, 220, 215, 200],  # Gedung 2
    [390, 400, 385, 410, 395]   # Gedung 3
])

# Rata-rata konsumsi daya per gedung (menyusuri kolom -> axis=1)
rata_per_gedung = np.mean(daya_gedung, axis=1)
print("Rata-rata konsumsi per gedung:", rata_per_gedung)

# Menemukan indeks gedung tertinggi dan terendah menggunakan np.argmax dan np.argmin
indeks_terboros = np.argmax(rata_per_gedung)
indeks_terhemat = np.argmin(rata_per_gedung)

print(f"Gedung paling boros daya: Gedung {indeks_terboros} (Rata-rata: {rata_per_gedung[indeks_terboros]:.1f} kWh)")
print(f"Gedung paling hemat daya: Gedung {indeks_terhemat} (Rata-rata: {rata_per_gedung[indeks_terhemat]:.1f} kWh)")

# Output:
# Rata-rata konsumsi per gedung: [320. 465. 210. 396.]
# Gedung paling boros daya: Gedung 1 (Rata-rata: 465.0 kWh)
# Gedung paling hemat daya: Gedung 2 (Rata-rata: 210.0 kWh)
Pembahasan: Parameter axis=1 menghitung nilai rata-rata melintang dari kiri ke kanan untuk setiap baris (gedung). Fungsi np.argmax() dan np.argmin() sangat berguna untuk menemukan indeks lokasi nilai ekstrem (terbesar atau terkecil) tanpa perlu mengurutkan data terlebih dahulu.


Discussion (0)
We store your optional name, your comment, and technical hashes (not your raw IP address) to prevent spam. A functional cookie lets you edit or delete your own comments from this browser. To request deletion, use the contact page.
No comments yet. Start the discussion.