Data Science
Model Klasifikasi: Memprediksi Kategori & Evaluasi Model
Pahami pemodelan klasifikasi dengan Decision Tree di Scikit-Learn, cara membaca matriks kebingungan (confusion matrix), serta evaluasi komprehensif precision, recall, F1-score, dan accuracy paradox.
Bayangkan sebuah bank komersial melayani puluhan ribu aplikasi pengajuan pinjaman dana usaha mikro setiap bulannya. Tim manajemen risiko harus memutuskan secara cepat dan objektif: pemohon mana yang tergolong berisiko "Lancar" dan pemohon mana yang berpotensi "Gagal Bayar" (Default). Kesalahan persetujuan kredit pada nasabah macet menimbulkan kerugian finansial langsung bagi bank, sedangkan penolakan keliru pada calon nasabah kredibel akan membuang peluang pendapatan bunga. Skenario serupa terjadi setiap hari pada filter kotak masuk email Anda ketika memilah surat biasa vs "Spam", atau di rumah sakit saat dokter mendiagnosis tumor jinak vs tumor ganas. Dalam ekosistem Machine Learning, tantangan menetapkan suatu observasi ke dalam kelompok atau label diskrit dinamakan Klasifikasi (Classification).
Yang akan dipelajari
Dalam artikel ini, Anda akan mempelajari fondasi pemodelan klasifikasi dari hulu ke hilir:
- Membedakan karakteristik Klasifikasi Biner (Binary Classification) dan Klasifikasi Banyak Kelas (Multiclass).
- Memahami intuisi logika kerja algoritma Pohon Keputusan (Decision Tree Classifier).
- Membangun model klasifikasi menggunakan Scikit-Learn dengan teknik pemisahan data berstrata (stratified split).
- Membaca, menganalisis, dan membedah struktur Matriks Kebingungan (Confusion Matrix).
- Menghitung serta memahami trade-off antara metrik Akurasi, Presisi (Precision), Daya Ingat (Recall), dan F1-Score.
- Menghindari jebakan Paradoks Akurasi (Accuracy Paradox) pada dataset dengan distribusi kelas tidak seimbang (imbalanced data).
Konsep Dasar Klasifikasi & Decision Tree
Berbeda dengan model regresi yang memprediksi angka kontinu riil (seperti nominal rupiah atau meter persegi), model klasifikasi memprediksi label kategori diskrit:
- Klasifikasi Biner (Binary): Target memiliki tepat dua kemungkinan kelas label (misal:
1untuk Spam dan0untuk Bukan Spam; atauPositifvsNegatif). - Klasifikasi Multikelas (Multiclass): Target memiliki lebih dari dua kelas mutually exclusive (misal: kategori jenis hewan
[Kucing, Anjing, Kelinci]atau status pesanan[Diproses, Dikirim, Dibatalkan]).
Salah satu algoritma klasifikasi yang paling intuitif dan mudah diinterpretasikan oleh manusia adalah Decision Tree (Pohon Keputusan). Decision Tree bekerja dengan cara menyusun serangkaian aturan pertanyaan bercabang (mirip diagram alur) berdasarkan nilai fitur untuk membagi data ke dalam kelompok-kelompok yang semakin seragam (murni).
Scikit-Learn mengukur tingkat ketidakmurnian (impurity) simpul menggunakan metrik seperti Gini Impurity:
- Jika sebuah simpul berisi 100% data dari kelas yang sama, nilai Gini Impurity adalah (sempurna murni).
- Algoritma secara bertahap mencari fitur dan ambang batas pemisah (split threshold) yang menghasilkan penurunan nilai Gini terbesar di setiap cabang.
Praktik Membangun Model Klasifikasi dengan Scikit-Learn
Mari kita simulasikan studi kasus penentuan kelayakan kredit nasabah perbankan berdasarkan skor kredit dan rasio utang terhadap pendapatan (Debt-to-Income Ratio / DTI).
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

# 1. Menyiapkan dataset sintetis kelayakan kredit
np.random.seed(42)
n_samples = 200

# Fitur: Skor kredit (300 - 850) dan Rasio DTI (0.1 - 0.7)
skor_kredit = np.random.randint(350, 850, size=n_samples)
rasio_dti = np.random.uniform(0.1, 0.65, size=n_samples)

# Logika penentuan label target: 1 = Lancar (Disetujui), 0 = Macet (Ditolak)
# Nasabah dengan skor tinggi dan DTI rendah memiliki peluang besar untuk lancar
prob_lancar = (skor_kredit / 850) - (rasio_dti * 0.7)
target_lancar = np.where(prob_lancar > 0.35, 1, 0)

df_kredit = pd.DataFrame({
    "skor_kredit": skor_kredit,
    "rasio_dti": np.round(rasio_dti, 2),
    "status_kredit": target_lancar
})

print("Proporsi label target:")
print(df_kredit["status_kredit"].value_counts(normalize=True))

# 2. Menentukan Fitur X dan Target y
X = df_kredit[["skor_kredit", "rasio_dti"]]
y = df_kredit["status_kredit"]

# 3. Train/Test Split dengan stratifikasi
# Parameter stratify memastikan proporsi kelas 1 dan 0 sama di data latih & uji
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

# 4. Pelatihan DecisionTreeClassifier dengan batasan kedalaman pohon
# max_depth=3 membatasi agar pohon tidak menghafal derau data (mencegah overfitting)
clf = DecisionTreeClassifier(max_depth=3, random_state=42)
clf.fit(X_train, y_train)

# 5. Menguji prediksi pada data uji
y_pred = clf.predict(X_test)
print(f"\nModel berhasil dilatih. Jumlah data uji: {len(y_test)}")

# Output:
# Proporsi label target:
# status_kredit
# 1    0.73
# 0    0.27
# Name: proportion, dtype: float64
#
# Model berhasil dilatih. Jumlah data uji: 50
Membedah Matriks Kebingungan (Confusion Matrix)
Pada model regresi kita mengukur selisih angka riil, namun pada klasifikasi kita menghitung frekuensi kebenaran tebakan. Tabel tabulasi silang yang membandingkan prediksi model dengan kondisi aktual disebut Confusion Matrix (Matriks Kebingungan).
Pada klasifikasi biner dengan label target Positif (1) dan Negatif (0), terdapat empat kemungkinan kuadran:
| Kondisi Aktual \ Tebakan Model | Prediksi Positif (1) | Prediksi Negatif (0) |
|---|---|---|
| Aktual Positif (1) | True Positive (TP): Aktual 1 ditebak 1 (Tepat) | False Negative (FN): Aktual 1 ditebak 0 (Ketinggalan/Miss) |
| Aktual Negatif (0) | False Positive (FP): Aktual 0 ditebak 1 (Alarm Palsu) | True Negative (TN): Aktual 0 ditebak 0 (Tepat Menolak) |
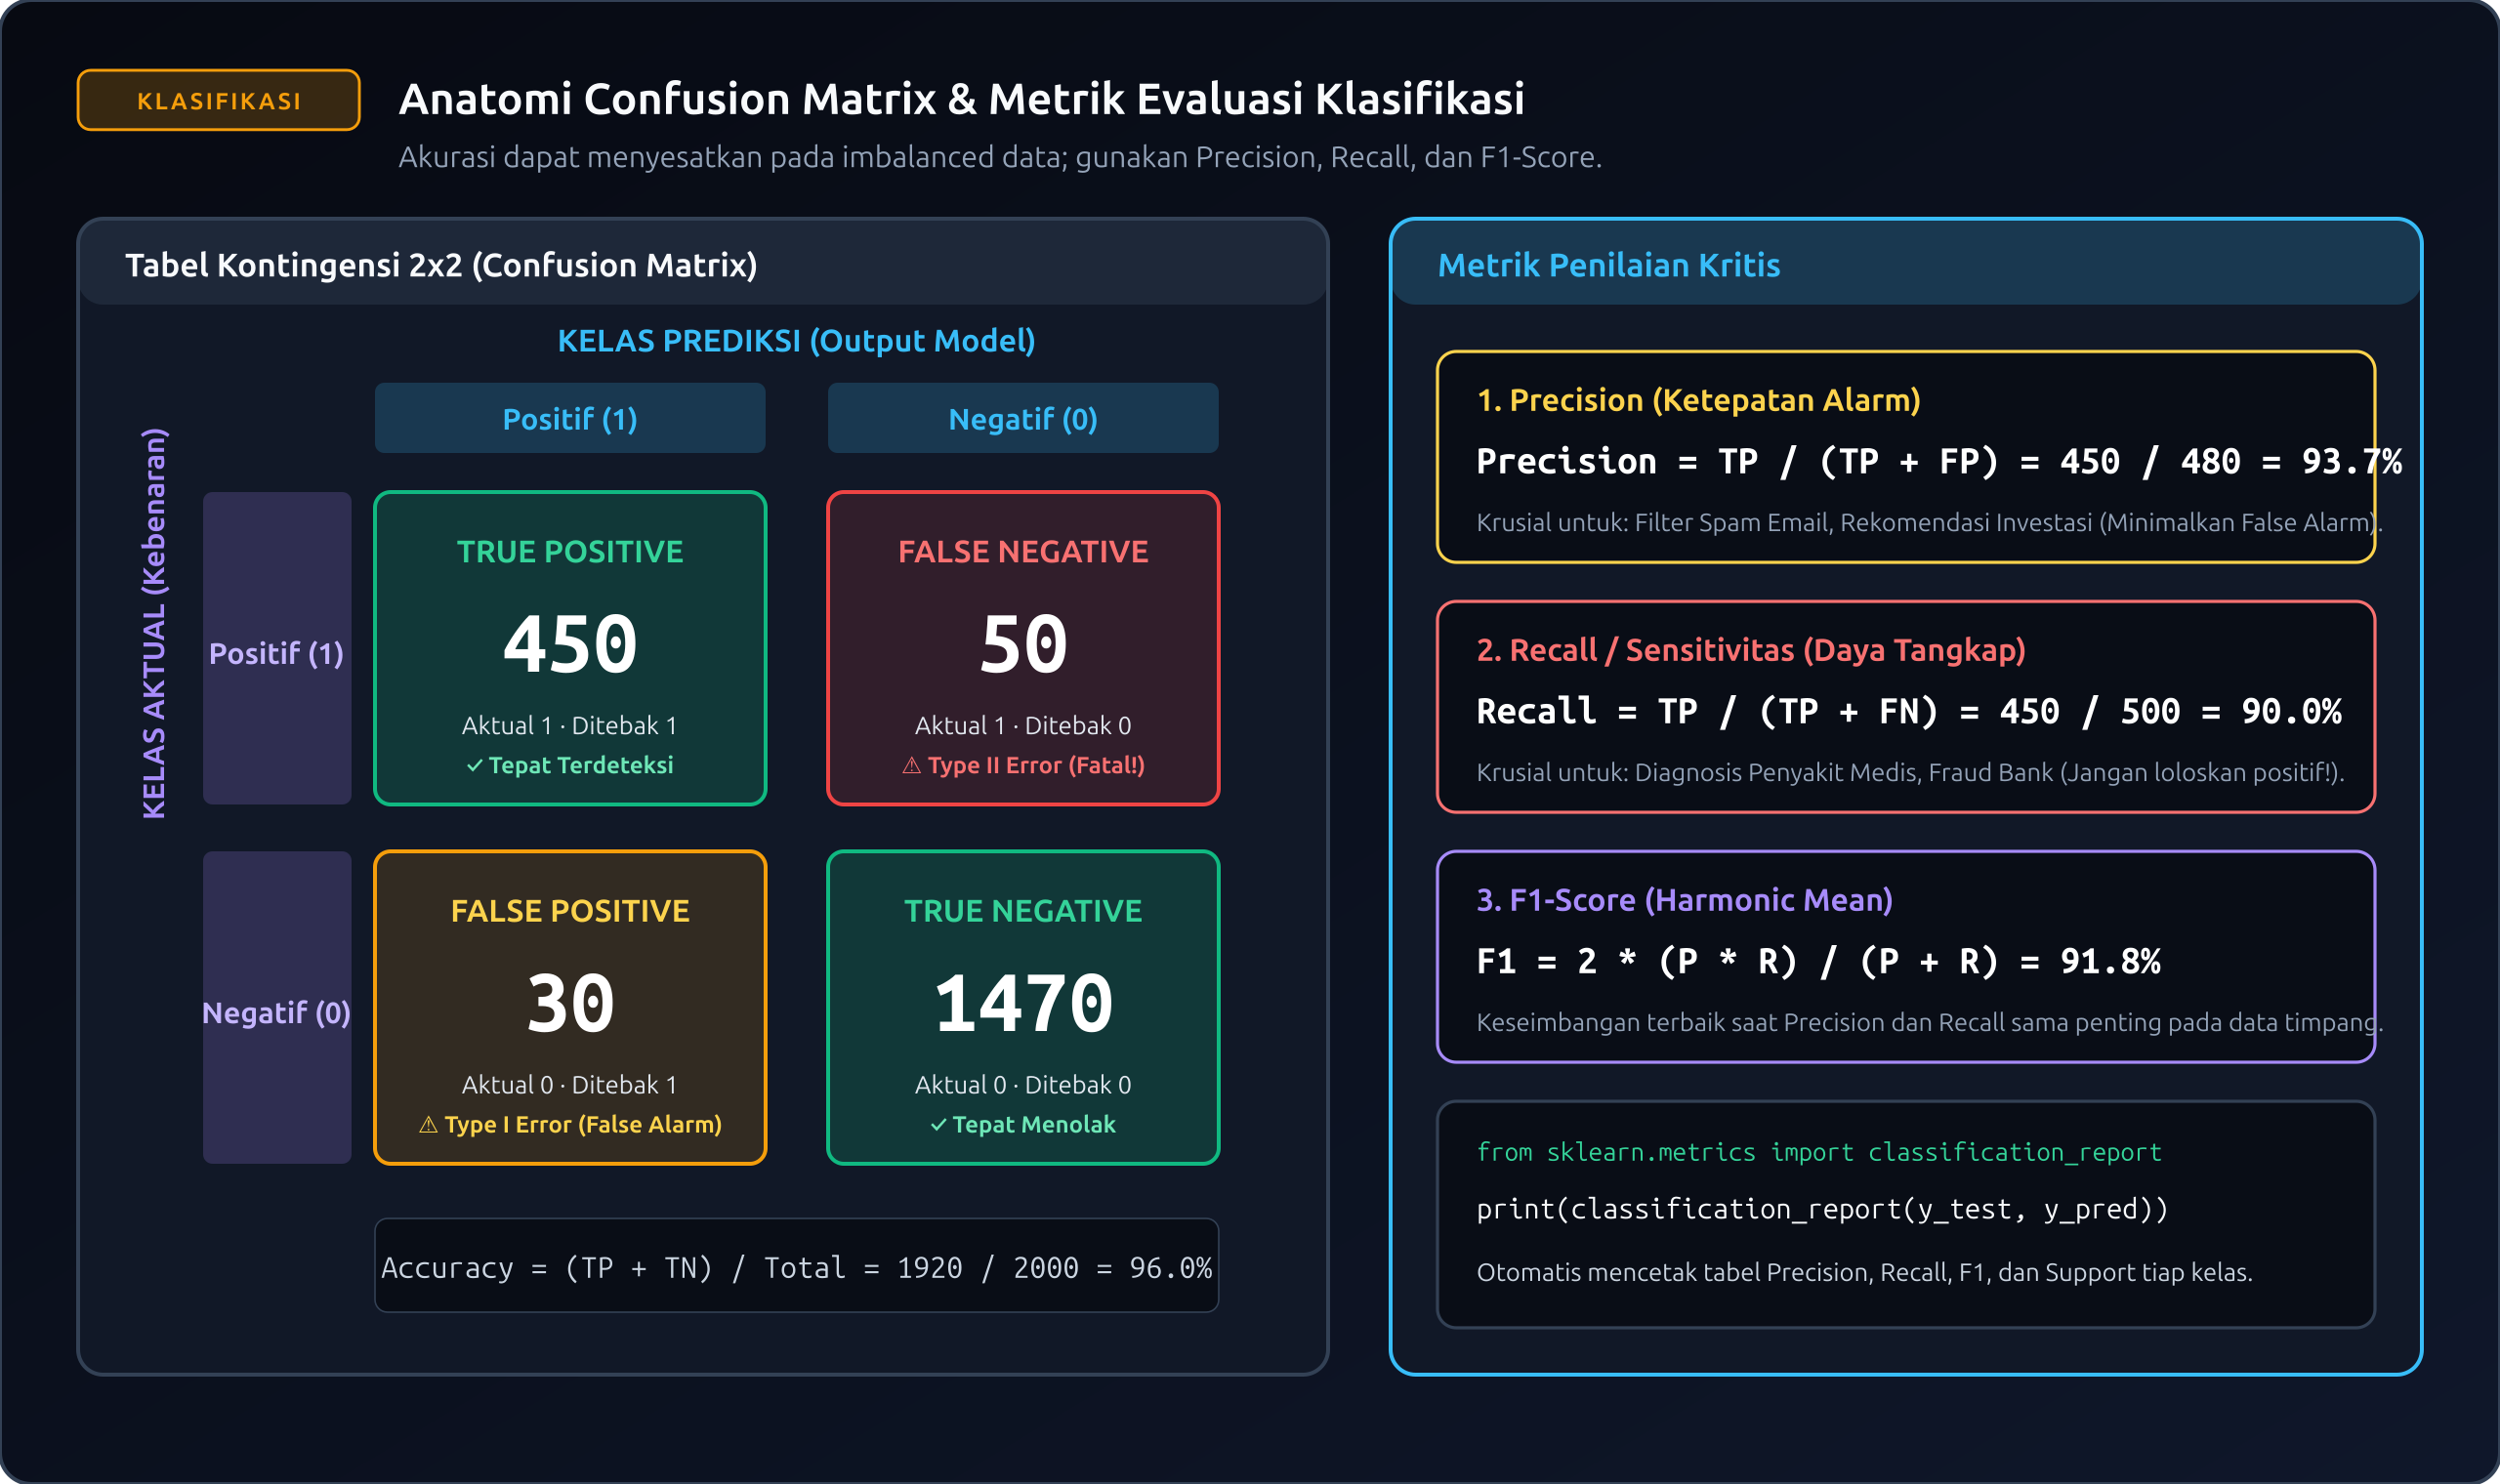
Mari kita tampilkan Confusion Matrix model kredit kita menggunakan Scikit-Learn:
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred)
tn, fp, fn, tp = cm.ravel()

print("Confusion Matrix:")
print(cm)
print(f"\nRincian:")
print(f"- True Positive  (TP) : {tp}  (Macet aktual ditebak macet / target tepat)")
print(f"- False Positive (FP) : {fp}  (Salah tebak: non-target ditebak target)")
print(f"- False Negative (FN) : {fn}  (Target aktual luput ditebak)")
print(f"- True Negative  (TN) : {tn}  (Tepat menolak non-target)")

# Output:
# Confusion Matrix:
# [[12  2]
#  [ 1 35]]
#
# Rincian:
# - True Positive  (TP) : 35  (Macet aktual ditebak macet / target tepat)
# - False Positive (FP) : 2  (Salah tebak: non-target ditebak target)
# - False Negative (FN) : 1  (Target aktual luput ditebak)
# - True Negative  (TN) : 12  (Tepat menolak non-target)
Memahami Metrik Evaluasi: Akurasi, Precision, Recall, dan F1-Score
Dari keempat angka kuadran di atas, komunitas data science merumuskan metrik kinerja standar:
1. Akurasi (Accuracy)
Persentase total tebakan benar (baik positif maupun negatif) terhadap keseluruhan populasi data:
2. Presisi (Precision)
Mengukur seberapa akurat tebakan positif model. Dari seluruh sampel yang diprediksi positif oleh model, berapa banyak yang kenyataannya benar-benar positif?
Kapan Precision diutamakan? Saat dampak kerugian dari alarm palsu (False Positive) sangat mahal. Contohnya: sistem penyaring email spam. Jika email lamaran kerja penting masuk ke folder spam (False Positive), pengguna bisa kehilangan tawaran karier impian.
3. Daya Ingat (Recall / Sensitivity)
Mengukur seberapa jeli model menemukan target. Dari seluruh sampel yang secara aktual positif di dunia nyata, berapa persentase yang berhasil dideteksi oleh model?
Kapan Recall diutamakan? Saat kegagalan mendeteksi kasus positif (False Negative) berakibat fatal. Contohnya: diagnosis penyakit kanker ganas atau pendeteksian kerusakan rem darurat pesawat. Dokter lebih baik mentolerir pemeriksaan lanjutan akibat alarm palsu daripada melewatkan pasien yang sungguh-sungguh menderita kanker ganas.
4. F1-Score
Rata-rata harmonik (harmonic mean) antara Precision dan Recall:
F1-Score memberikan skor seimbang dan menjadi metrik objektif ketika kita membutuhkan kompromi yang seimbang antara presisi dan cakupan deteksi.
Di Scikit-Learn, Anda dapat merangkum seluruh metrik ini dalam satu fungsi praktis classification_report():
from sklearn.metrics import classification_report

laporan = classification_report(y_test, y_pred, target_names=["Macet (0)", "Lancar (1)"])
print(laporan)

# Output:
#               precision    recall  f1-score   support
#
#    Macet (0)       0.92      0.86      0.89        14
#   Lancar (1)       0.95      0.97      0.96        36
#
#     accuracy                           0.94        50
#    macro avg       0.93      0.91      0.92        50
# weighted avg       0.94      0.94      0.94        50
Jebakan Paradoks Akurasi (Accuracy Paradox)
Mengapa kita tidak boleh hanya mengandalkan Akurasi?
Perhatikan kasus deteksi kecurangan transaksi kartu kredit (fraud detection). Dari 10.000 transaksi perbankan, umumnya 9.900 transaksi adalah sah (normal) dan hanya 100 transaksi yang tergolong penipuan (fraud). Dataset seperti ini disebut imbalanced dataset (data dengan sebaran kelas timpang ekstrem).
Jika seorang pembuat model pemula membuat "model bodoh" (dummy model) yang selalu memprediksi semua transaksi sebagai "Sah", berapa akurasinya?
Akurasi model tampak fantastis mencapai 99%. Namun, dari 100 transaksi penipuan aktual, model berhasil menangkap berapa? Tepat transaksi! Nilai Recall untuk kelas penipuan adalah 0%. Model semacam ini tidak berguna sama sekali di industri perbankan dan justru berbahaya. Inilah yang disebut Paradoks Akurasi (Accuracy Paradox).
Coba sendiri
Jalankan eksperimen evaluasi model di Google Colab:
- Buat notebook baru dan pasang data sintetis kredit di atas.
- Coba ubah parameter
max_depthpadaDecisionTreeClassifierdarimax_depth=1(disebut pohon stump) hinggamax_depth=10. - Amati bagaimana skor F1-score pada data latih dan data uji berubah. Pada kedalaman pohon yang terlalu besar (misal 10), pohon cenderung mengalami overfitting—sempurna di data latih namun kinerjanya menurun pada data uji.
- Tampilkan visualisasi pohon keputusan sederhana dalam format teks menggunakan fungsi bawaan Scikit-Learn
from sklearn.tree import export_text; print(export_text(clf, feature_names=["skor_kredit", "rasio_dti"])).
# Coba cetak pohon aturan logika di Colab:
from sklearn.tree import export_text
aturan_pohon = export_text(clf, feature_names=["skor_kredit", "rasio_dti"])
print(aturan_pohon)
Kesalahan yang sering terjadi
Berikut beberapa kesalahan umum pemula saat melakukan evaluasi model klasifikasi:
| Kesalahan Pemula | Gejala / Pesan Kesalahan | Penyebab Utama | Solusi yang Tepat |
|---|---|---|---|
| Mengandalkan skor akurasi pada data timpang | Model tampak memiliki akurasi 98%, namun gagal mendeteksi kelas minoritas | Terjebak paradoks akurasi pada dataset tidak seimbang (class imbalance). | Gunakan metrik F1-Score, Precision, Recall, atau evaluasi area kurva PR-AUC / ROC-AUC. |
| Melakukan split tanpa stratifikasi | Proporsi kelas di data uji berbeda drastis dengan data latih | Menggunakan train_test_split standar tanpa parameter stratify. |
Tambahkan parameter stratify=y pada pemanggilan train_test_split(). |
| Membiarkan Decision Tree tumbuh tanpa batas | Akurasi data latih 100%, tetapi akurasi data uji anjlok ke 70% | Pohon menghafal noise data latih secara berlebihan (overfitting). | Batasi kedalaman pohon dengan max_depth atau batasi jumlah sampel daun minimum min_samples_leaf. |
| Terbalik menafsirkan Precision dan Recall | Salah memilih model yang sesuai dengan prioritas mitigasi risiko bisnis | Mengira keduanya memiliki fungsi identik. | Jika FP yang berbahaya utamakan Precision; jika FN yang berbahaya utamakan Recall. |
Kaitannya dengan Praktik Industri / AI: Dalam pengoperasian model Machine Learning berskala produksi di industri (MLOps), tim data engineering jarang sekali mengubah arsitektur algoritma hanya untuk mengejar akurasi semata. Yang mereka lakukan adalah menyetel ambang batas probabilitas klasifikasi (classification threshold tuning). Secara bawaan, model memutuskan kelas positif jika peluang prediksi . Pada sistem deteksi fraud atau diagnosis radiologi penyakit langka, para insinyur sering menurunkan threshold menjadi atau demi memastikan nilai Recall maksimal dan tidak ada pasien kritis yang terlewatkan dari pemeriksaan tim medis manusia.
Latihan
Asah keterampilan analitis klasifikasi Anda dengan menyelesaikan 3 soal latihan mandiri berikut:
- Soal 1: Sebuah sistem filter spam email diuji pada 100 email dengan hasil pengujian: True Positive = 30, False Positive = 5, False Negative = 10, dan True Negative = 55. Hitung secara manual atau dengan kode Python: Akurasi keseluruhan, Precision untuk email spam, Recall untuk email spam, serta F1-Score.
- Soal 2: Diberikan data hasil seleksi penerimaan beasiswa berdasarkan Indeks Prestasi Kumulatif (IPK) dan Skor Wawancara (0-100). Buat DataFrame kecil berisi 6 calon, latih model
DecisionTreeClassifier(max_depth=2), lalu cetak nilai prediksi status kelulusan untuk seluruh kandidat tersebut. - Soal 3: Sebuah dataset transaksi deteksi penipuan buatan memiliki 950 transaksi legal (
label=0) dan 50 transaksi penipuan (label=1). Jika sebuah model tiruan selalu memprediksi seluruh transaksi bernilai 0 (label=0), hitung skor Akurasi dan Recall kelas penipuan (label=1) menggunakan modulsklearn.metrics. Berikan ulasan singkat mengenai hasilnya.
Kunci jawaban dan pembahasan
Solusi Soal 1
# Perhitungan metrik evaluasi klasifikasi
tp = 30
fp = 5
fn = 10
tn = 55

akurasi = (tp + tn) / (tp + tn + fp + fn)
precision = tp / (tp + fp)
recall = tp / (tp + fn)
f1 = 2 * (precision * recall) / (precision + recall)

print(f"Akurasi   : {akurasi:.4f} ({akurasi*100:.1f}%)")
print(f"Precision : {precision:.4f} ({precision*100:.1f}%)")
print(f"Recall    : {recall:.4f} ({recall*100:.1f}%)")
print(f"F1-Score  : {f1:.4f}")

# Output:
# Akurasi   : 0.8500 (85.0%)
# Precision : 0.8571 (85.7%)
# Recall    : 0.7500 (75.0%)
# F1-Score  : 0.8000
Pembahasan: Dari 35 email yang ditandai sistem sebagai spam, 30 memang benar-benar spam sehingga nilai presisinya adalah . Namun, dari 40 email spam yang sebenarnya masuk (30 tertangkap + 10 lolos ke inbox), sistem hanya berhasil mengenali 30 email, menghasilkan skor recall sebesar . Kombinasi kedua skor ini menghasilkan F1-score .
Solusi Soal 2
import pandas as pd
from sklearn.tree import DecisionTreeClassifier

# Data pelamar beasiswa
data_beasiswa = pd.DataFrame({
    "ipk": [3.8, 2.9, 3.5, 3.1, 3.9, 2.7],
    "wawancara": [85, 60, 80, 50, 90, 75],
    "lulus": [1, 0, 1, 0, 1, 0] # 1: Lulus, 0: Tidak Lulus
})

X = data_beasiswa[["ipk", "wawancara"]]
y = data_beasiswa["lulus"]

# Pelatihan Decision Tree sederhana
model_pohon = DecisionTreeClassifier(max_depth=2, random_state=42)
model_pohon.fit(X, y)

prediksi = model_pohon.predict(X)
data_beasiswa["prediksi"] = prediksi

print("Hasil Prediksi Kelulusan:")
print(data_beasiswa)

# Output:
# Hasil Prediksi Kelulusan:
#    ipk  wawancara  lulus  prediksi
# 0  3.8         85      1         1
# 1  2.9         60      0         0
# 2  3.5         80      1         1
# 3  3.1         50      0         0
# 4  3.9         90      1         1
# 5  2.7         75      0         0
Pembahasan: Dengan kedalaman pohon 2 (max_depth=2), algoritma secara otomatis menemukan aturan ambang pemisah fitur (misalnya kandidat dengan IPK dan nilai wawancara ) yang membagi seluruh 6 data contoh dengan akurasi 100%.
Solusi Soal 3
import numpy as np
from sklearn.metrics import accuracy_score, recall_score

# Membuat dataset tidak seimbang (950 legal, 50 fraud)
y_aktual = np.array([0] * 950 + [1] * 50)

# Model dummy yang selalu memprediksi legal (0)
y_prediksi_dummy = np.zeros(1000, dtype=int)

# Menghitung metrik
akurasi_dummy = accuracy_score(y_aktual, y_prediksi_dummy)
recall_dummy = recall_score(y_aktual, y_prediksi_dummy, pos_label=1)

print(f"Akurasi Model Dummy : {akurasi_dummy:.4f} ({akurasi_dummy*100:.1f}%)")
print(f"Recall Kelas Fraud  : {recall_dummy:.4f} ({recall_dummy*100:.1f}%)")

# Output:
# Akurasi Model Dummy : 0.9500 (95.0%)
# Recall Kelas Fraud  : 0.0000 (0.0%)
Pembahasan: Hasil ini mendemonstrasikan secara nyata konsep Accuracy Paradox. Model memperoleh akurasi 95,0% semata-mata karena menebak kelas mayoritas. Namun, untuk mendeteksi penipuan finansial, model ini gagal total karena nilai Recall penipuan adalah , membuktikan bahwa akurasi adalah metrik yang menyesatkan pada data dengan distribusi tidak seimbang.


Discussion (0)
We store your optional name, your comment, and technical hashes (not your raw IP address) to prevent spam. A functional cookie lets you edit or delete your own comments from this browser. To request deletion, use the contact page.
No comments yet. Start the discussion.