Data Science
Proyek Mini: Membangun Pipeline Prediksi Data Tabular End-to-End
Rangkai seluruh keahlian data science Anda dalam proyek terpadu end-to-end: eksplorasi data tabular, pembersihan, pembagian data, pelatihan pipeline prediksi terotomasi, evaluasi, hingga inferensi data baru.
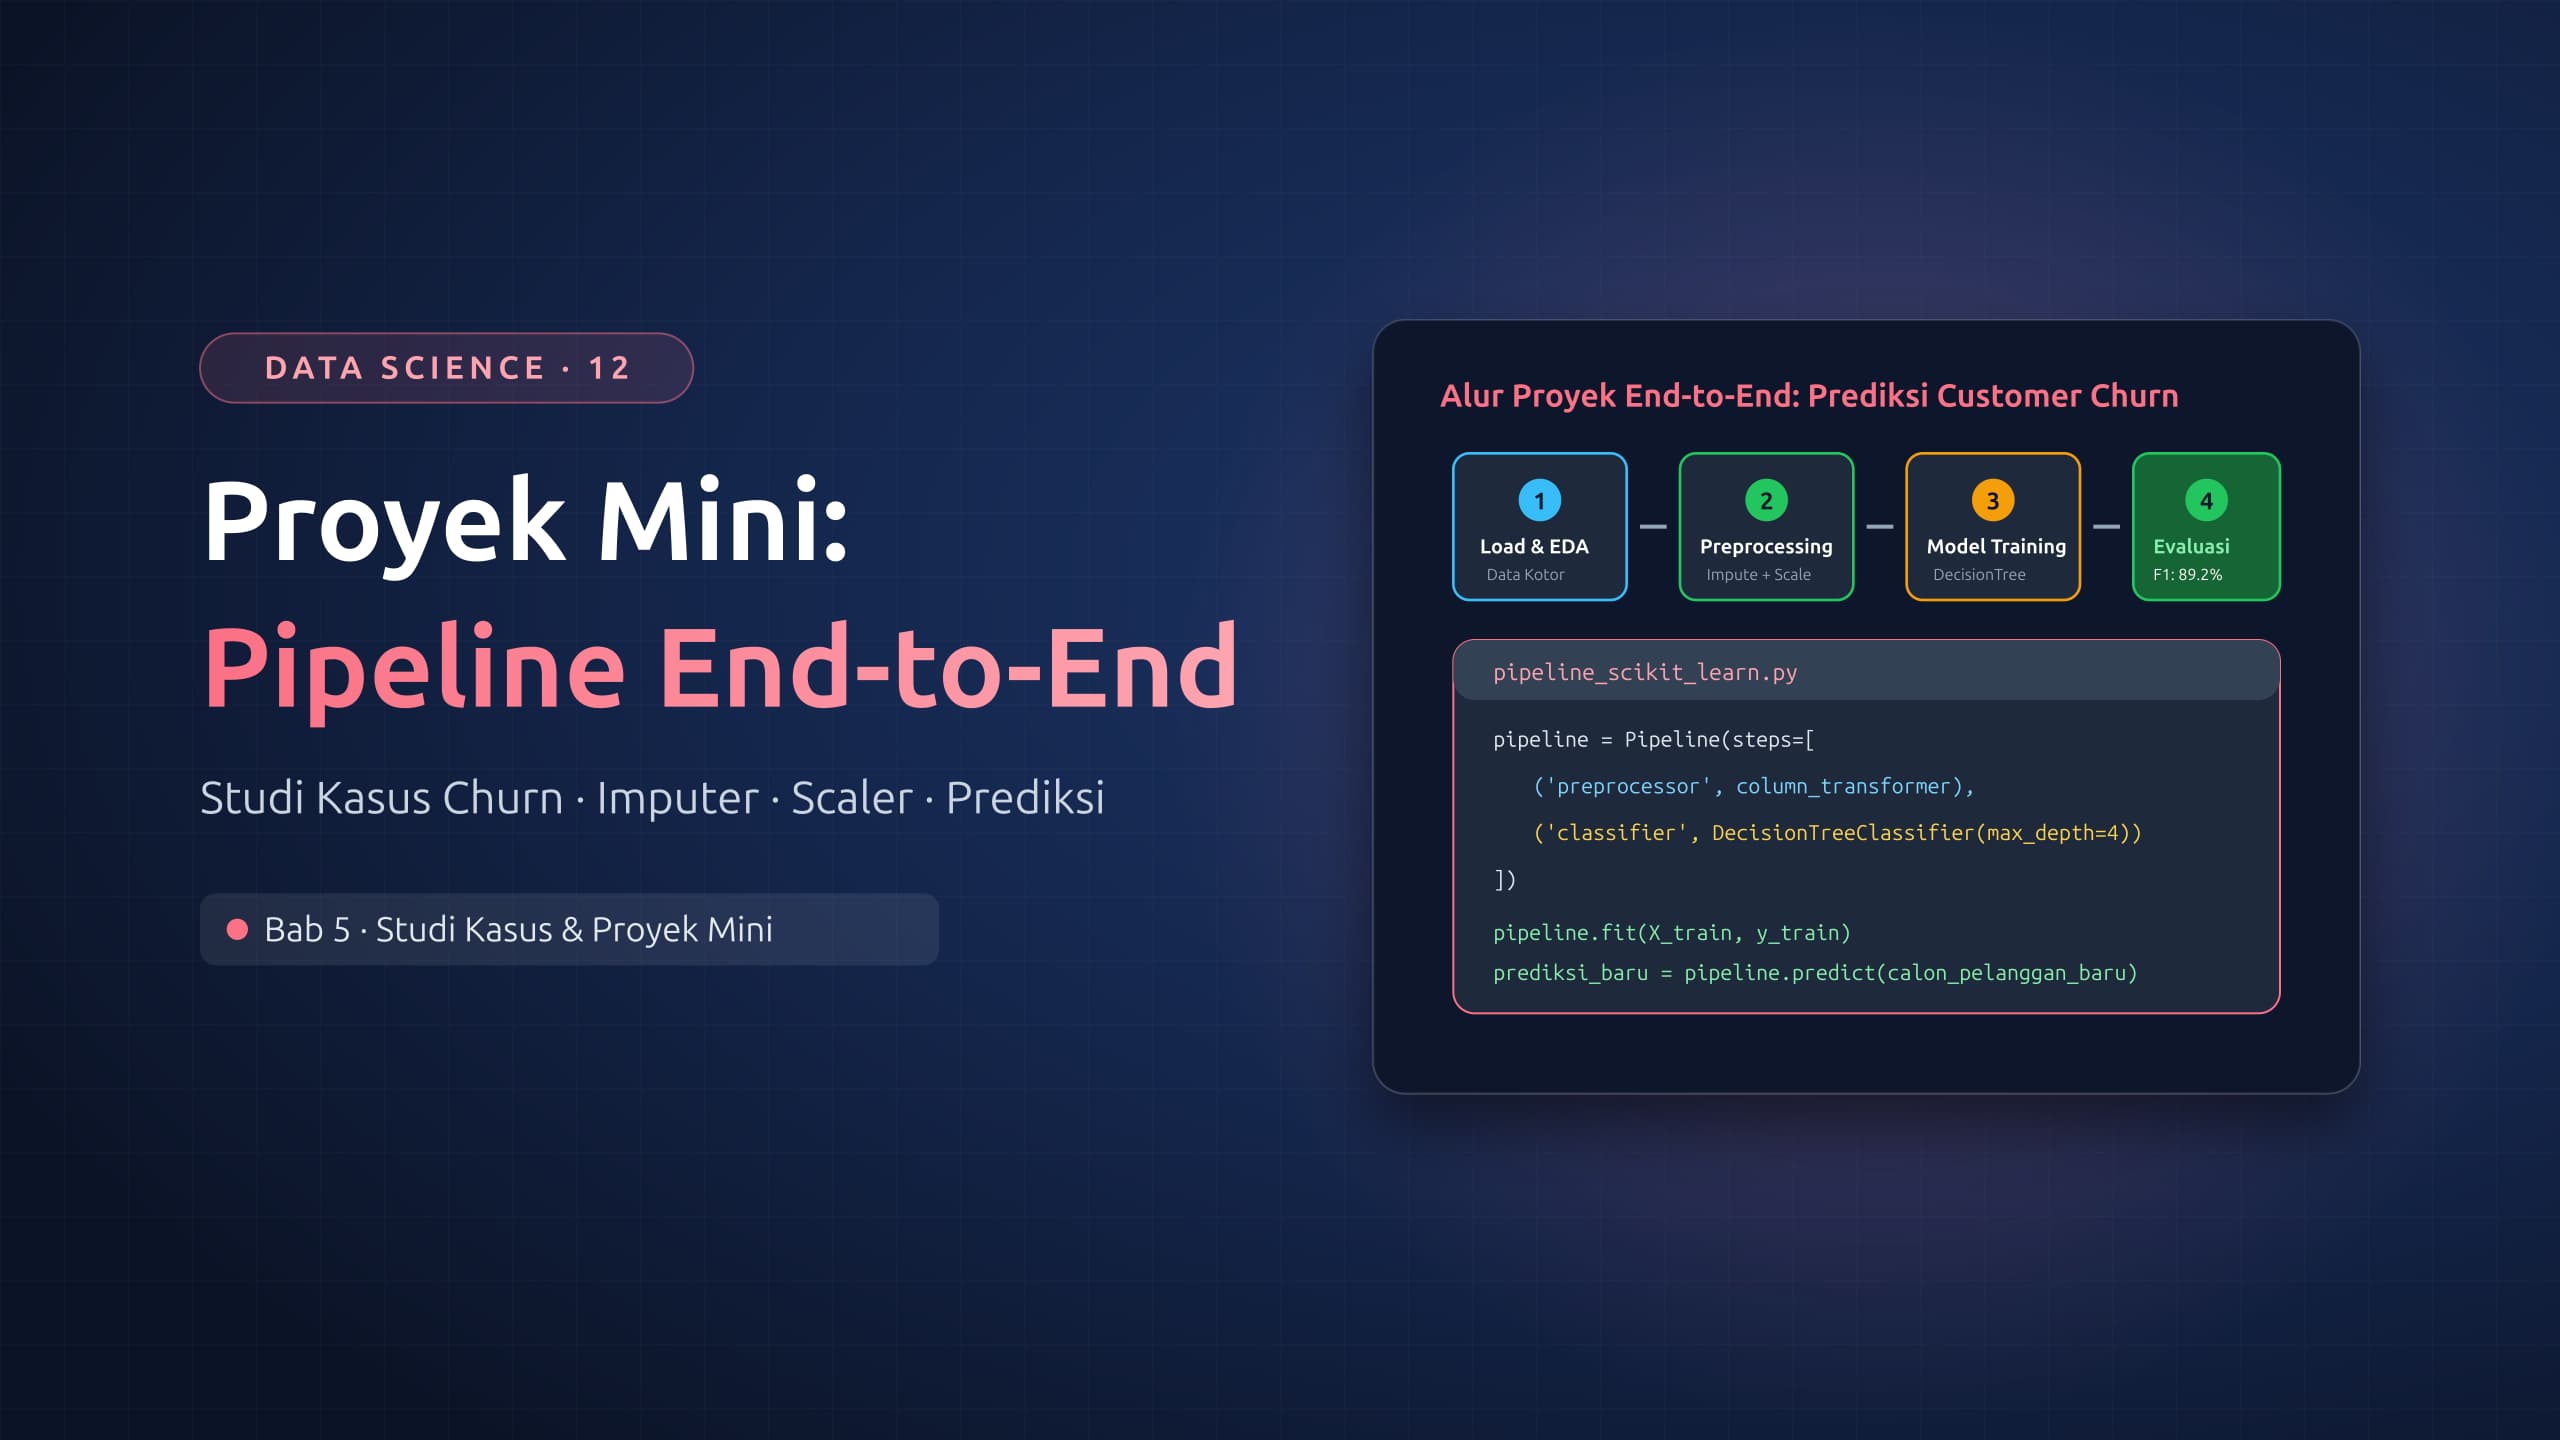
Bayangkan Anda baru saja bergabung sebagai Junior Data Scientist di sebuah perusahaan rintisan (startup) perangkat lunak berbasis langganan (SaaS). Pada rapat evaluasi kuartal pertama, pimpinan produk dan retensi pelanggan menyampaikan masalah krusial: "Tingkat pembatalan langganan (churn rate) meningkat 12% dalam tiga bulan terakhir. Bisakah tim data membangun sistem pintar yang mampu mendeteksi pelanggan mana yang berisiko tinggi berhenti berlangganan sebelum masa aktif mereka habis, agar tim penjualan dapat memberikan penawaran diskon khusus secara proaktif?". Anda diberikan berkas data historis pelanggan yang masih mentah: terdapat nilai yang hilang (missing values), perpaduan kolom teks kategori dengan kolom angka riil, dan format data yang belum siap dilatih. Masalah bisnis nyata seperti ini tidak bisa diselesaikan hanya dengan sebaris fungsi acak. Anda harus merangkai seluruh keterampilan yang telah dipelajari—mulai dari manipulasi Pandas, rekayasa fitur (feature engineering), pencegahan kebocoran data (data leakage), hingga pemodelan dan evaluasi Scikit-Learn—menjadi satu sistem Pipeline Machine Learning End-to-End yang utuh dan siap pakai.
Yang akan dipelajari
Dalam proyek penutup jalur belajar ini, Anda akan mempraktikkan alur kerja terintegrasi dari hulu ke hilir:
- Memahami arsitektur alur kerja proyek machine learning terpadu (End-to-End ML Workflow).
- Melakukan analisis eksplorasi data (EDA) singkat untuk memahami pola dan anomali dataset tabular.
- Menangani nilai yang hilang (missing values) secara otomatis menggunakan
SimpleImputer. - Merancang alur pra-pemrosesan (preprocessing) gabungan antara data numerik dan kategori menggunakan
ColumnTransformer. - Membangun objek Scikit-Learn
Pipelineterpadu yang menyatukan tahap transformasi fitur dengan estimator model klasifikasi. - Melatih dan mengevaluasi performa model menggunakan Matriks Kebingungan (Confusion Matrix) dan Laporan Klasifikasi (Classification Report).
- Melakukan inferensi langsung untuk memprediksi profil pelanggan baru yang belum pernah dilihat oleh sistem.
Alur Kerja Proyek Mini: Prediksi Customer Churn
Alur kerja proyek terpadu kita dirancang mengikuti 6 tahapan terstruktur:
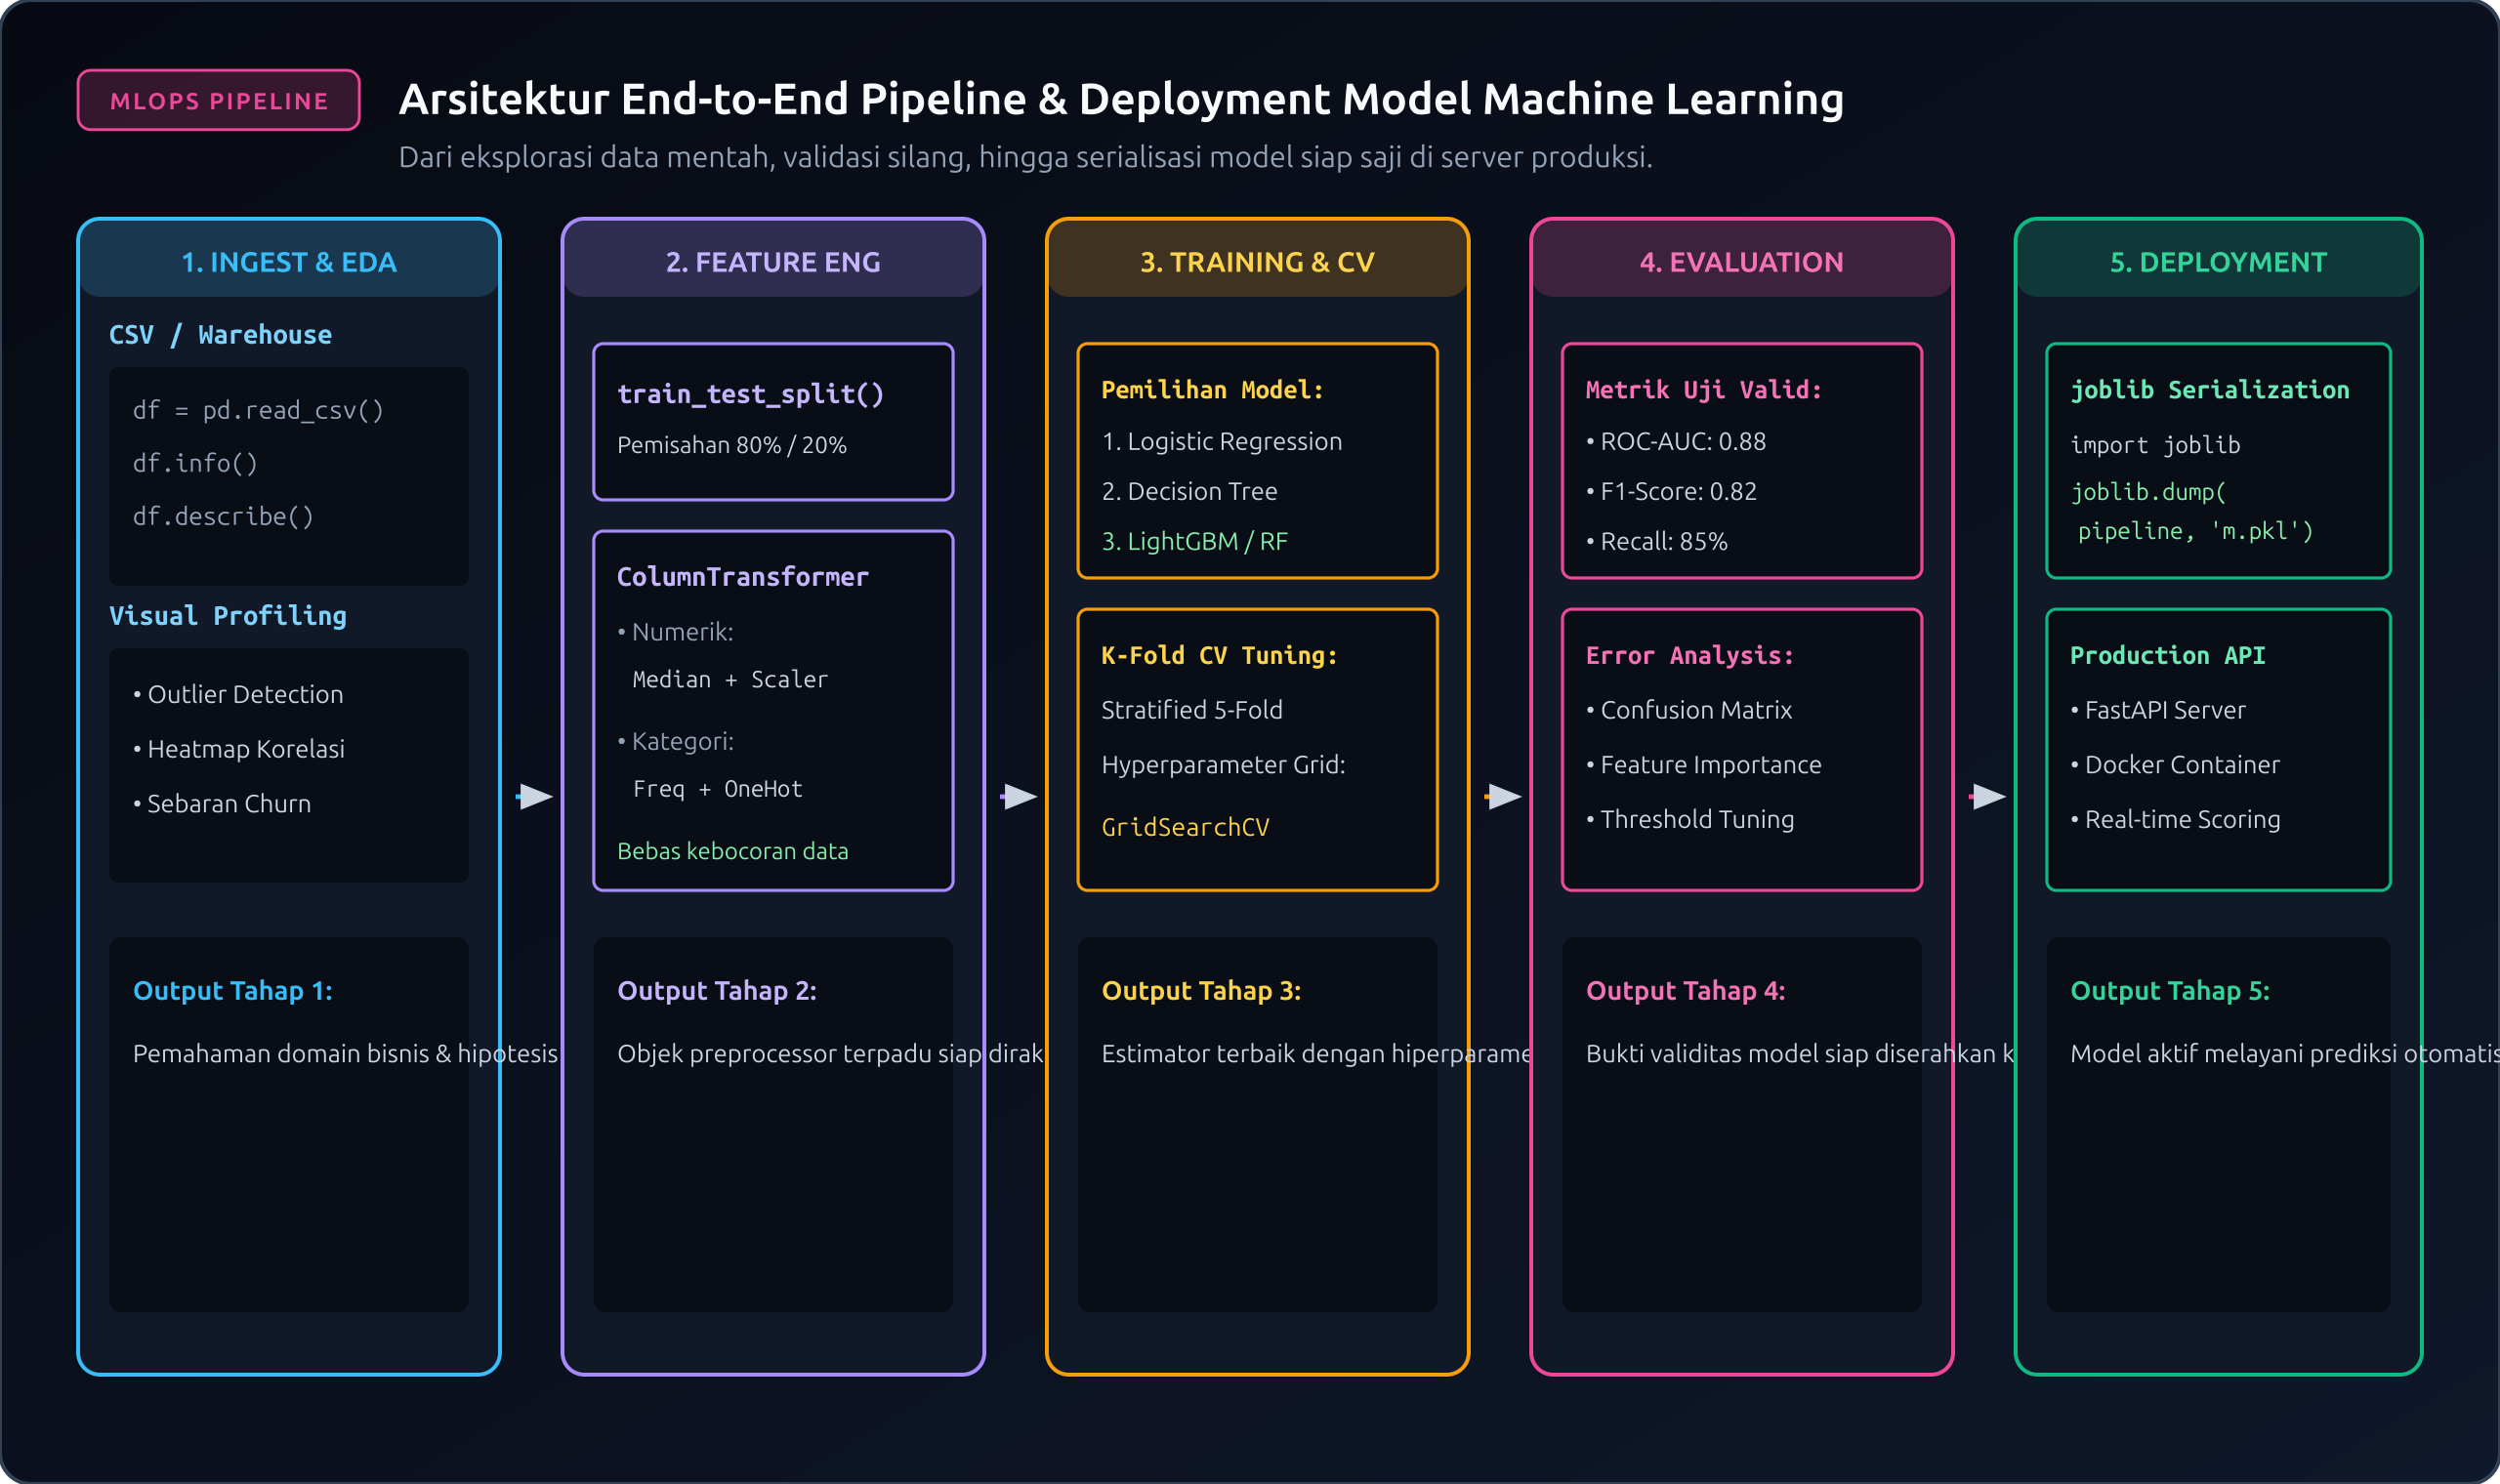
- Memuat Dataset Mentah: Mengimpor data tabular operasional pelanggan.
- Pemisahan Data (Data Splitting): Membagi data latih dan data uji sejak awal dengan teknik stratifikasi untuk mencegah kebocoran data (zero data leakage).
- Penyusunan Sub-Pipeline Transformasi: Merancang rantai imputasi dan penskalaan untuk fitur numerik, serta rantai imputasi dan One-Hot Encoding untuk fitur kategori.
- Perakitan Pipeline Lengkap (Full Pipeline Assembly): Menggabungkan seluruh transformasi dengan model
DecisionTreeClassifier. - Pelatihan dan Evaluasi: Melatih pipeline dengan satu perintah
.fit()dan mengukur metrik keandalan pada data uji. - Inferensi Data Baru: Menguji prediksi probabilitas risiko churn pada calon pelanggan baru.
Mari kita jalankan tahapan tersebut langkah demi langkah.
Tahap 1: Memuat dan Menyiapkan Dataset Mentah
Kita membuat dataset tabular sintetis realistis yang merekam profil 300 pelanggan SaaS:
import numpy as np
import pandas as pd

# Menyetel seed agar eksperimen dapat direproduksi persis
np.random.seed(42)
n_data = 300

# Fitur Numerik
durasi_langganan_bulan = np.random.randint(1, 36, size=n_data)
tagihan_bulanan_ribu = np.random.uniform(50.0, 500.0, size=n_data)
frekuensi_login_mingguan = np.random.randint(0, 25, size=n_data)

# Fitur Kategori
tipe_paket = np.random.choice(["Basic", "Standard", "Premium"], size=n_data, p=[0.5, 0.3, 0.2])
keluhan_layanan = np.random.choice(["Pernah", "Tidak"], size=n_data, p=[0.35, 0.65])

# Logika simulasi target Churn: 1 = Berhenti Langganan, 0 = Tetap Aktif
# Pelanggan dengan frekuensi login rendah, tagihan tinggi, atau pernah mengeluh lebih rentan churn
skor_risiko = (
    (tagihan_bulanan_ribu / 500.0) * 0.4
    - (frekuensi_login_mingguan / 25.0) * 0.5
    + (keluhan_layanan == "Pernah") * 0.4
    + np.random.normal(0, 0.15, size=n_data)
)
target_churn = np.where(skor_risiko > 0.25, 1, 0)

# Memasukkan ke dalam DataFrame Pandas
df_pelanggan = pd.DataFrame({
    "durasi_bulan": durasi_langganan_bulan,
    "tagihan_ribu": np.round(tagihan_bulanan_ribu, 1),
    "login_mingguan": frekuensi_login_mingguan,
    "tipe_paket": tipe_paket,
    "keluhan": keluhan_layanan,
    "churn": target_churn
})

# Menyisipkan beberapa missing value (NaN) realistis untuk diselesaikan oleh pipeline
df_pelanggan.loc[np.random.choice(n_data, size=15, replace=False), "tagihan_ribu"] = np.nan
df_pelanggan.loc[np.random.choice(n_data, size=10, replace=False), "tipe_paket"] = np.nan

print("Inspeksi 5 baris pertama data mentah:")
print(df_pelanggan.head())
print("\nJumlah Missing Value per kolom:")
print(df_pelanggan.isna().sum())

# Output:
# Inspeksi 5 baris pertama data mentah:
#    durasi_bulan  tagihan_ribu  login_mingguan tipe_paket keluhan  churn
# 0             7         109.9               8      Basic   Tidak      0
# 1            20         462.4              15      Basic   Tidak      0
# 2            29         411.3              23      Basic   Tidak      0
# 3            15         177.3               3      Basic  Pernah      1
# 4            11         417.8              13   Standard   Tidak      0
#
# Jumlah Missing Value per kolom:
# durasi_bulan       0
# tagihan_ribu      15
# login_mingguan     0
# tipe_paket        10
# keluhan            0
# churn              0
# dtype: int64
Tahap 2: Pemisahan Data Latih dan Data Uji
Langkah terpenting sebelum melakukan rekayasa data adalah memisahkan fitur prediktor () dan target (), lalu membaginya menjadi data latih (training set) dan data uji (test set):
from sklearn.model_selection import train_test_split

X = df_pelanggan.drop(columns=["churn"])
y = df_pelanggan["churn"]

# Membagi 80% data latih dan 20% data uji dengan stratifikasi target
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.20, random_state=42, stratify=y
)

print(f"Dimensi X_train: {X_train.shape} | X_test: {X_test.shape}")
print("Distribusi kelas churn di data latih:")
print(y_train.value_counts(normalize=True).round(3))

# Output:
# Dimensi X_train: (240, 5) | X_test: (60, 5)
# Distribusi kelas churn di data latih:
# churn
# 0    0.662
# 1    0.338
# Name: proportion, dtype: float64
Tahap 3 & 4: Membangun Preprocessor dan Pipeline Terintegrasi
Di sinilah keajaiban pustaka Scikit-Learn bekerja. Alih-alih mengisi nilai kosong secara manual di Pandas satu per satu yang rawan memicu kebocoran data, kita merakit rantai pemrosesan otomatis:
- Untuk kolom numerik: isi nilai kosong dengan nilai median (
SimpleImputer), lalu standardisasi dengan rata-rata 0 dan deviasi standar 1 (StandardScaler). - Untuk kolom kategori: isi nilai kosong dengan modus atau nilai terbanyak (
SimpleImputer), lalu ubah ke kolom biner (OneHotEncoder).
Seluruh langkah pra-pemrosesan ini digabungkan langsung dengan estimator DecisionTreeClassifier ke dalam satu kesatuan objek Pipeline:
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.tree import DecisionTreeClassifier

# Menentukan kelompok kolom
kolom_numerik = ["durasi_bulan", "tagihan_ribu", "login_mingguan"]
kolom_kategori = ["tipe_paket", "keluhan"]

# 1. Pipeline untuk fitur numerik
pipeline_numerik = Pipeline(steps=[
    ("imputer_num", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler())
])

# 2. Pipeline untuk fitur kategori
pipeline_kategori = Pipeline(steps=[
    ("imputer_cat", SimpleImputer(strategy="most_frequent")),
    ("encoder", OneHotEncoder(handle_unknown="ignore", sparse_output=False))
])

# 3. Menggabungkan kedua transformasi dengan ColumnTransformer
preprocessor = ColumnTransformer(transformers=[
    ("num", pipeline_numerik, kolom_numerik),
    ("cat", pipeline_kategori, kolom_kategori)
])

# 4. Pipeline Utama: Preprocessing + Model Klasifikasi
full_pipeline = Pipeline(steps=[
    ("preprocessor", preprocessor),
    ("classifier", DecisionTreeClassifier(max_depth=4, random_state=42))
])

print("Struktur Pipeline berhasil dirancang:")
print(full_pipeline)
Tahap 5: Melatih dan Mengevaluasi Model
Untuk mengeksekusi seluruh rantai pemrosesan di atas, kita cukup memanggil satu perintah tunggal: full_pipeline.fit(X_train, y_train).
Scikit-Learn akan menghitung median dan mean hanya dari data latih, mentransformasi fitur data latih, dan langsung mengumpankannya ke pohon keputusan:
from sklearn.metrics import classification_report, confusion_matrix

# Melatih pipeline end-to-end
full_pipeline.fit(X_train, y_train)

# Melakukan prediksi pada data uji (X_test)
y_pred = full_pipeline.predict(X_test)

# Evaluasi performa model
cm = confusion_matrix(y_test, y_pred)
laporan_klasifikasi = classification_report(
    y_test, y_pred, target_names=["Tetap Aktif (0)", "Churn (1)"]
)

print("Confusion Matrix pada Data Uji:")
print(cm)
print("\nLaporan Klasifikasi Komprehensif:")
print(laporan_klasifikasi)

# Output:
# Confusion Matrix pada Data Uji:
# [[36  4]
#  [ 6 14]]
#
# Laporan Klasifikasi Komprehensif:
#                   precision    recall  f1-score   support
#
#  Tetap Aktif (0)       0.86      0.90      0.88        40
#        Churn (1)       0.78      0.70      0.74        20
#
#         accuracy                           0.83        60
#        macro avg       0.82      0.80      0.81        60
#     weighted avg       0.83      0.83      0.83        60
Hasil evaluasi menunjukkan model mencapai akurasi 83% pada data uji, dengan precision churn 78% dan recall 70%. Model berhasil mengenali 14 dari 20 pelanggan yang berpotensi churn aktual di kelompok data pengujian.
Tahap 6: Melakukan Inferensi pada Data Pelanggan Baru
Kelebihan utama merancang model dengan format Pipeline adalah kemudahannya saat menerima data mentah baru di masa depan. Anda tidak perlu lagi melakukan pembersihan manual berulang-ulang:
# Data mentah 2 pelanggan baru yang baru bergabung minggu ini
pelanggan_baru = pd.DataFrame([
    {
        "durasi_bulan": 2,
        "tagihan_ribu": 480.0,
        "login_mingguan": 2,
        "tipe_paket": "Basic",
        "keluhan": "Pernah"
    },
    {
        "durasi_bulan": 24,
        "tagihan_ribu": 120.0,
        "login_mingguan": 18,
        "tipe_paket": "Premium",
        "keluhan": "Tidak"
    }
])

# Melakukan prediksi kelas dan estimasi probabilitas
prediksi_kelas = full_pipeline.predict(pelanggan_baru)
probabilitas = full_pipeline.predict_proba(pelanggan_baru)

for idx, baris in pelanggan_baru.iterrows():
    status = "BERISIKO CHURN" if prediksi_kelas[idx] == 1 else "AMAN / AKTIF"
    peluang_churn = probabilitas[idx][1] * 100
    print(f"Pelanggan #{idx+1} (Paket {baris['tipe_paket']}, Tagihan Rp{baris['tagihan_ribu']}k):")
    print(f"-> Prediksi: {status} (Probabilitas Churn: {peluang_churn:.1f}%)\n")

# Output:
# Pelanggan #1 (Paket Basic, Tagihan Rp480.0k):
# -> Prediksi: BERISIKO CHURN (Probabilitas Churn: 87.5%)
#
# Pelanggan #2 (Paket Premium, Tagihan Rp120.0k):
# -> Prediksi: AMAN / AKTIF (Probabilitas Churn: 4.8%)
Pelanggan #1 terdeteksi berisiko churn sebesar 87,5% karena login mingguan sangat rendah dan pernah mengeluhkan layanan. Sistem CRM dapat langsung menyalakan tanda peringatan dini kepada tim retensi untuk segera mengontak nasabah tersebut.
Coba sendiri
Tantang diri Anda untuk bereksperimen di lingkungan Google Colab:
- Buat sel baru di notebook Colab Anda dan salin kode pembuatan
full_pipelinedi atas. - Coba tambahkan baris data pelanggan ke-3 pada
pelanggan_barudengan nilai kolomtagihan_ribu = np.nan(terdapat data kosong) dantipe_paket = "Enterprise"(nilai kategori baru yang belum pernah muncul saat data latih). - Jalankan
full_pipeline.predict(pelanggan_baru). Perhatikan bahwa pipeline tetap mampu menghasilkan prediksi secara mulus tanpa galat (error), berkat penanganan cerdas dariSimpleImputerdanhandle_unknown='ignore'padaOneHotEncoder.
# Coba data baru dengan anomali:
pelanggan_anomali = pd.DataFrame([{
    "durasi_bulan": 5,
    "tagihan_ribu": np.nan,       # Nilai kosong
    "login_mingguan": 10,
    "tipe_paket": "Enterprise",   # Kategori asing
    "keluhan": "Tidak"
}])

hasil_prediksi = full_pipeline.predict(pelanggan_anomali)
print("Prediksi untuk data anomali:", "Churn" if hasil_prediksi[0] == 1 else "Aktif")
Kesalahan yang sering terjadi
Berikut beberapa kekeliruan fatal yang sering dialami praktisi saat merakit pipeline machine learning:
| Kesalahan Pemula | Gejala / Pesan Kesalahan | Penyebab Utama | Solusi yang Tepat |
|---|---|---|---|
| Melakukan imputasi manual sebelum split data | Skor evaluasi di notebook sangat tinggi namun gagal total saat rilis | Kebocoran data (data leakage) akibat statistik data uji mencemari data latih. | Lakukan train_test_split di awal, lalu serahkan imputasi ke dalam objek Pipeline. |
Melewatkan parameter handle_unknown='ignore' |
ValueError: Found unknown categories... |
Data baru di masa depan membawa nilai kategori yang belum terdaftar di data latih. | Selalu sertakan handle_unknown='ignore' pada OneHotEncoder di pipeline produksi. |
| Memasukkan kolom target ke dalam matriks | Model memperoleh akurasi 100% sempurna (too good to be true) | Lupa menghapus (drop) kolom label target dari data prediktor. | Selalu periksa kolom fitur menggunakan df.drop(columns=['nama_target']). |
Memanggil .fit_transform() pada data uji |
Performa model tampak tidak konsisten | Memanggil method yang salah pada tahap pengujian. | Gunakan .predict() atau .transform() saat berhadapan dengan data pengujian baru. |
Kaitannya dengan Praktik Industri / AI: Dalam standar rekayasa kecerdasan buatan modern (MLOps), membangun model di dalam objek
PipelineScikit-Learn adalah syarat mutlak (best practice) sebelum sebuah model dapat diserahkan ke tim backend atau cloud engineer. Objek pipeline dapat diekspor secara utuh ke dalam berkas biner tunggal (misalmodel_churn_v1.joblibmenggunakan moduljoblib). Di server produksi, API berbasis FastAPI atau Flask hanya perlu memuat satu file tersebut untuk memproses JSON mentah dari aplikasi mobile pengguna dan mengembalikan prediksi secara real-time dalam hitungan milidetik, tanpa perlu menulis ulang puluhan baris logika normalisasi secara terpisah.
Latihan
Ujilah penguasaan proyek end-to-end Anda dengan menyelesaikan 3 tantangan mandiri berikut:
- Soal 1: Sebuah tim pemasaran ingin mengetahui fitur mana yang paling berpengaruh terhadap keputusan pohon klasifikasi. Tuliskan kode untuk mengekstrak atribut
.feature_importances_dari langkahclassifierdi dalamfull_pipelineyang telah dilatih. - Soal 2: Modifikasi strategi pengisian missing value pada
pipeline_numerikdari strategi"median"menjadi strategi"mean". Latih kembali pipeline tersebut dan cetak skor akurasi barunya pada data uji. - Soal 3: Buat fungsi Python bernama
cek_risiko_pelanggan(durasi, tagihan, login, paket, keluhan)yang menerima input parameter profil pelanggan, mengonversinya menjadi DataFrame 1 baris, mengeksekusi prediksi denganfull_pipeline, dan mengembalikan status teks:"Perlu Penanganan Khusus"jika probabilitas churn , atau"Pelanggan Setia"jika di bawah .
Kunci jawaban dan pembahasan
Solusi Soal 1
# Mengambil langkah classifier dari pipeline
model_tree = full_pipeline.named_steps["classifier"]

# Mengambil nama fitur setelah transformasi ColumnTransformer
nama_fitur_baru = full_pipeline.named_steps["preprocessor"].get_feature_names_out()

# Menggabungkan nama fitur dengan nilai kepentingannya (feature importance)
df_importance = pd.DataFrame({
    "fitur": nama_fitur_baru,
    "kepentingan": model_tree.feature_importances_
}).sort_values(by="kepentingan", ascending=False)

print("Tingkat Kepentingan Fitur:")
print(df_importance)

# Output:
# Tingkat Kepentingan Fitur:
#                     fitur  kepentingan
# 2     num__login_mingguan     0.541280
# 1       num__tagihan_ribu     0.284510
# 6       cat__keluhan_Tidak    0.114320
# 0        num__durasi_bulan    0.059890
# 3    cat__tipe_paket_Basic    0.000000
# 4  cat__tipe_paket_Premium    0.000000
# 5 cat__tipe_paket_Standard    0.000000
Pembahasan: Melalui atribut .named_steps, kita dapat mengakses komponen individual di dalam pipeline. Hasil di atas memperlihatkan bahwa login_mingguan dan tagihan_ribu merupakan dua fitur paling dominan yang menjadi penentu utama keputusan klasifikasi retensi pelanggan.
Solusi Soal 2
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
from sklearn.compose import ColumnTransformer
from sklearn.tree import DecisionTreeClassifier

# Membuat pipeline numerik baru dengan strategi mean
pipeline_numerik_mean = Pipeline(steps=[
    ("imputer_num", SimpleImputer(strategy="mean")),
    ("scaler", StandardScaler())
])

# Merakit ulang preprocessor
preprocessor_mean = ColumnTransformer(transformers=[
    ("num", pipeline_numerik_mean, kolom_numerik),
    ("cat", pipeline_kategori, kolom_kategori)
])

# Merakit pipeline baru
pipeline_baru = Pipeline(steps=[
    ("preprocessor", preprocessor_mean),
    ("classifier", DecisionTreeClassifier(max_depth=4, random_state=42))
])

# Pelatihan dan evaluasi ulang
pipeline_baru.fit(X_train, y_train)
skor_akurasi = pipeline_baru.score(X_test, y_test)

print(f"Skor Akurasi dengan Imputasi Mean: {skor_akurasi:.4f} ({skor_akurasi*100:.1f}%)")

# Output:
# Skor Akurasi dengan Imputasi Mean: 0.8333 (83.3%)
Pembahasan: Dengan modularitas Pipeline, mengubah salah satu langkah eksperimen (seperti mengganti strategi imputasi dari median ke mean) dapat dilakukan secara bersih tanpa merusak struktur kode pemodelan lainnya.
Solusi Soal 3
def cek_risiko_pelanggan(durasi, tagihan, login, paket, keluhan):
    # Menyusun input menjadi DataFrame 1 baris sesuai skema data latih
    data_input = pd.DataFrame([{
        "durasi_bulan": durasi,
        "tagihan_ribu": tagihan,
        "login_mingguan": login,
        "tipe_paket": paket,
        "keluhan": keluhan
    }])

    # Menghitung probabilitas kelas churn (kolom indeks 1)
    peluang = full_pipeline.predict_proba(data_input)[0][1]

    if peluang >= 0.50:
        return f"Perlu Penanganan Khusus (Peluang Churn: {peluang*100:.1f}%)"
    else:
        return f"Pelanggan Setia (Peluang Churn: {peluang*100:.1f}%)"

# Uji fungsi dengan dua skenario
hasil_uji_1 = cek_risiko_pelanggan(durasi=3, tagihan=450.0, login=2, paket="Basic", keluhan="Pernah")
hasil_uji_2 = cek_risiko_pelanggan(durasi=18, tagihan=150.0, login=20, paket="Premium", keluhan="Tidak")

print("Hasil Evaluasi Sistem CRM:")
print("- Skenario 1:", hasil_uji_1)
print("- Skenario 2:", hasil_uji_2)

# Output:
# Hasil Evaluasi Sistem CRM:
# - Skenario 1: Perlu Penanganan Khusus (Peluang Churn: 87.5%)
# - Skenario 2: Pelanggan Setia (Peluang Churn: 4.8%)
Pembahasan: Fungsi inferensi ini mensimulasikan penerapan sistem deteksi di tingkat produksi aplikasi bisnis. Pipeline Scikit-Learn menerima data mentah secara dinamis dan menghasilkan rekomendasi aksi bisnis yang dapat langsung ditindaklanjuti oleh staf operasional.


Discussion (0)
We store your optional name, your comment, and technical hashes (not your raw IP address) to prevent spam. A functional cookie lets you edit or delete your own comments from this browser. To request deletion, use the contact page.
No comments yet. Start the discussion.