Data Science
Transformasi Data: GroupBy, Agregasi, dan Penggabungan Tabel
Kuasai transformasi data tingkat lanjut di Pandas dengan paradigma Split-Apply-Combine melalui GroupBy, agregasi multi-kolom, pengurutan, serta penggabungan dataset menggunakan Merge dan Concat.

Dalam skenario bisnis nyata, data mentah jarang sekali tersaji dalam satu tabel yang sudah rapi dan siap saji. Bayangkan seorang analis e-commerce yang memegang dua berkas terpisah: tabel transaksi penjualan harian berisi ratusan ribu baris dan tabel profil demografi pelanggan. Untuk menjawab pertanyaan sederhana manajemen seperti "Berapa rata-rata belanja bulanan pelanggan kategori VIP di setiap kota besar?", analisis sebaris demi sebaris tidak lagi memadai. Kita perlu mengelompokkan data berdasarkan segmen tertentu, menghitung ringkasan statistik secara simultan, dan menyatukan kembali potongan-potongan informasi dari tabel yang berbeda.
Di Pandas, kebutuhan manipulasi kompleks ini ditangani secara elegan lewat operasi GroupBy (berbasis paradigma Split-Apply-Combine) serta operasi penyatuan data melalui pd.merge() dan pd.concat(). Menguasai teknik transformasi ini adalah jembatan penting yang membedakan pemula dari praktisi data yang mampu meracik wawasan bisnis mendalam dari tumpukan data tabular mentah.
Yang akan dipelajari
Dalam panduan ini, kamu akan menguasai:
- Paradigma Split-Apply-Combine untuk analisis segmen data menggunakan
.groupby(). - Penerapan agregasi fleksibel multi-kolom dan fungsi kustom menggunakan metode
.agg(). - Pengurutan data dan penanganan indeks hasil agregasi (
as_index,reset_index(), dansort_values()). - Penggabungan struktural vertikal dan horizontal dengan
pd.concat(). - Penggabungan relasional antar-tabel berbasis kunci relasi menggunakan
pd.merge()(inner, left, right, dan outer join).
Konsep dan Intuisi: Split-Apply-Combine
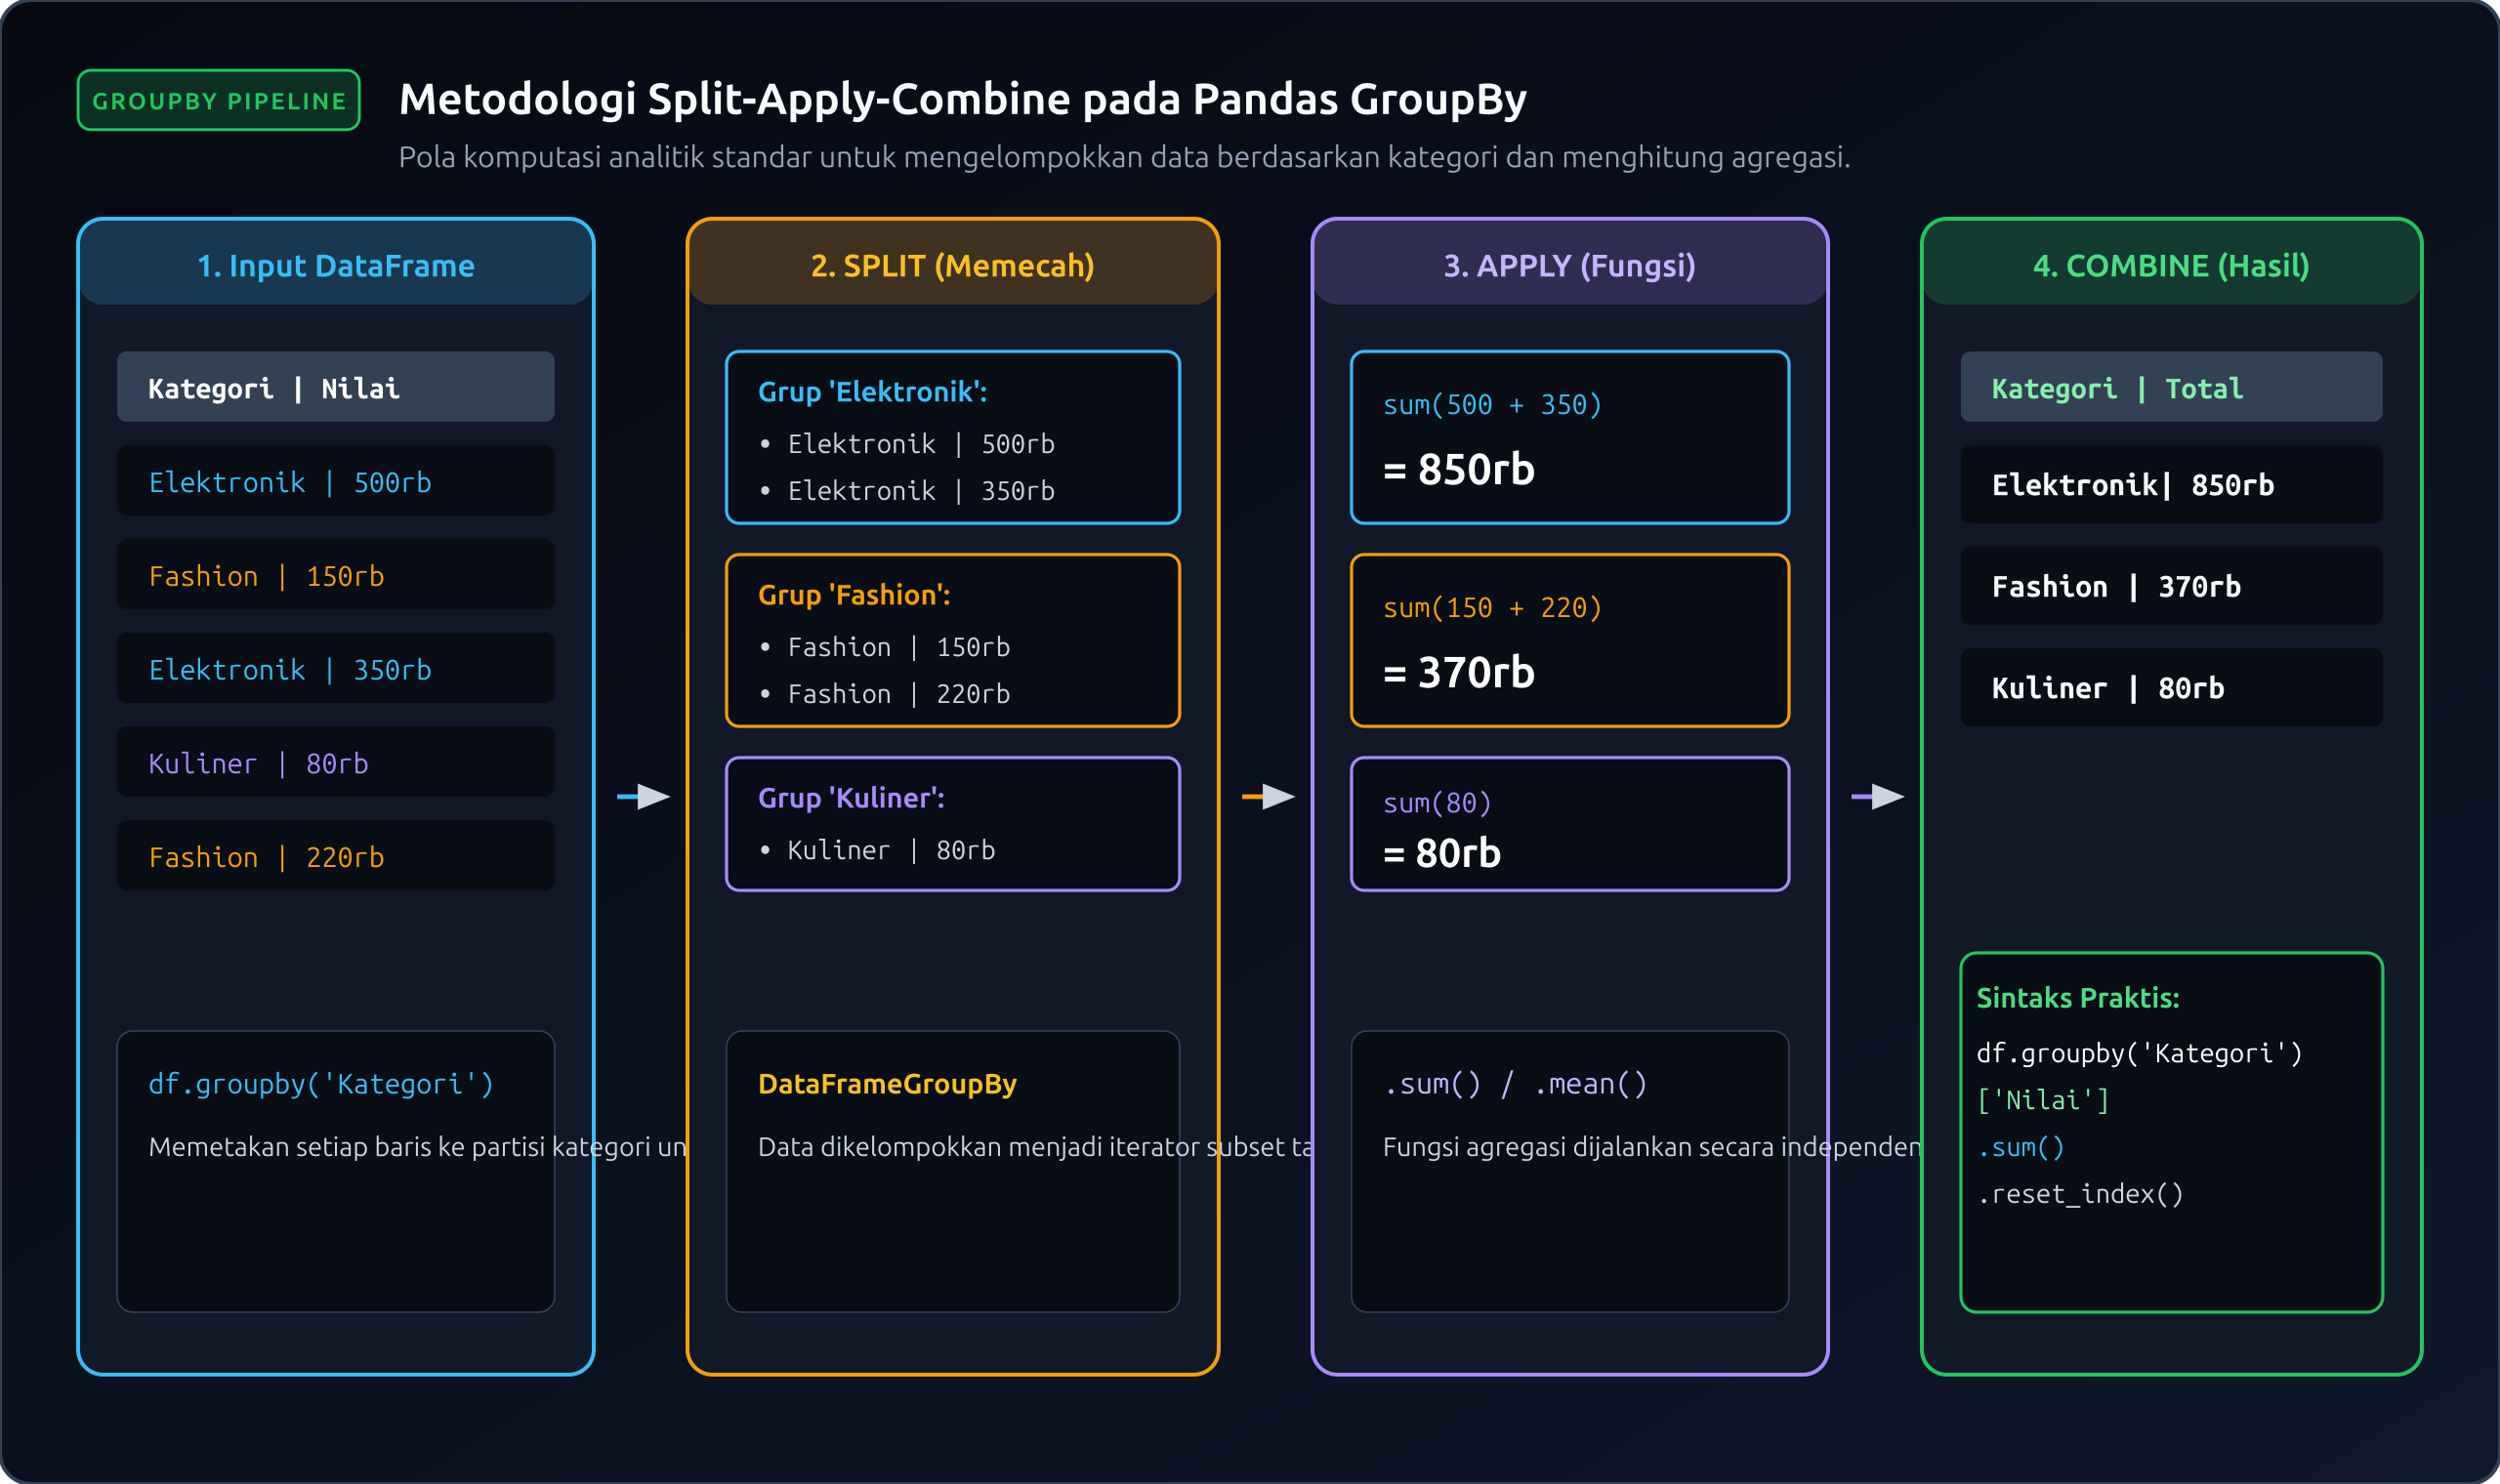
Konsep pengelompokan data di Pandas dipopulerkan oleh Hadley Wickham melalui pola pikir Split-Apply-Combine:
- Split (Memecah): Dataset besar dipecah menjadi beberapa kelompok data kecil berdasarkan nilai unik dari satu atau lebih kolom kunci (misalnya dikelompokkan per kategori cabang atau per bulan).
- Apply (Menerapkan Fungsi): Fungsi kalkulasi dijalankan secara independen pada masing-masing kelompok data tersebut. Kalkulasi bisa berupa agregasi (seperti
.mean(),.sum(),.count()), transformasi (standardisasi per grup), atau filtrasi. - Combine (Menggabungkan Kembali): Hasil kalkulasi dari setiap kelompok disatukan kembali ke dalam satu struktur ringkas berupa Series atau DataFrame baru.
Berikut visualisasi cara kerja Split-Apply-Combine:
Data Awal:
[Kategori | Nilai]
   A      |  10
   B      |  20
   A      |  30
   B      |  40

1. SPLIT:
   Kelompok A -> [10, 30]
   Kelompok B -> [20, 40]

2. APPLY (Fungsi Rata-rata / Mean):
   Kelompok A -> (10 + 30) / 2 = 20
   Kelompok B -> (20 + 40) / 2 = 30

3. COMBINE:
   [Kategori | Nilai_Mean]
      A      |     20
      B      |     30
Praktik Kode Bertahap
Mari kita simulasikan dataset transaksi penjualan ritel di beberapa kota untuk mempraktikkan konsep ini secara menyeluruh. Jalankan blok kode berikut di notebook Google Colab kamu.
1. Menyiapkan Dataset Transaksi Penjualan
import pandas as pd
import numpy as np

# Membuat DataFrame transaksi ritel
data_transaksi = {
    'transaksi_id': [101, 102, 103, 104, 105, 106, 107, 108],
    'pelanggan_id': ['C01', 'C02', 'C01', 'C03', 'C02', 'C01', 'C04', 'C03'],
    'kategori': ['Elektronik', 'Pakaian', 'Elektronik', 'Peralatan', 'Pakaian', 'Peralatan', 'Elektronik', 'Pakaian'],
    'kota': ['Jakarta', 'Surabaya', 'Jakarta', 'Bandung', 'Surabaya', 'Jakarta', 'Medan', 'Bandung'],
    'kuantitas': [1, 3, 2, 1, 2, 4, 1, 5],
    'total_belanja': [2500000, 450000, 5000000, 350000, 300000, 1200000, 1800000, 750000]
}

df_transaksi = pd.DataFrame(data_transaksi)
print("=== Data Transaksi Awal ===")
print(df_transaksi)
Output:
=== Data Transaksi Awal ===
   transaksi_id pelanggan_id    kategori      kota  kuantitas  total_belanja
0           101          C01  Elektronik   Jakarta          1        2500000
1           102          C02     Pakaian  Surabaya          3         450000
2           103          C01  Elektronik   Jakarta          2        5000000
3           104          C03   Peralatan   Bandung          1         350000
4           105          C02     Pakaian  Surabaya          2         300000
5           106          C01   Peralatan   Jakarta          4        1200000
6           107          C04  Elektronik     Medan          1        1800000
7           108          C03     Pakaian   Bandung          5         750000
2. GroupBy Dasar dan Agregasi Sederhana
Untuk mengetahui total omset dan jumlah barang terjual per kategori produk, gunakan metode .groupby() yang diikuti kolom target dan fungsi agregasi:
# Menghitung total belanja per kategori produk
omset_per_kategori = df_transaksi.groupby('kategori')['total_belanja'].sum()
print("=== Total Omset per Kategori ===")
print(omset_per_kategori)
Output:
=== Total Omset per Kategori ===
kategori
Elektronik    9300000
Pakaian       1500000
Peralatan     1550000
Name: total_belanja, dtype: int64
Secara default, kolom yang dijadikan acuan GroupBy akan berubah menjadi index baris. Jika ingin mempertahankan kolom tersebut sebagai kolom biasa dalam DataFrame, gunakan argumen as_index=False atau panggil .reset_index() di akhir rantai metode:
# GroupBy dengan as_index=False agar hasil tetap berupa DataFrame standar
ringkasan_kota = df_transaksi.groupby('kota', as_index=False)['total_belanja'].mean()
ringkasan_kota = ringkasan_kota.rename(columns={'total_belanja': 'rata_rata_belanja'})
print("=== Rata-Rata Belanja per Kota ===")
print(ringkasan_kota)
Output:
=== Rata-Rata Belanja per Kota ===
       kota  rata_rata_belanja
0   Bandung       5.500000e+05
1   Jakarta       2.900000e+06
2     Medan       1.800000e+06
3  Surabaya       3.750000e+05
3. Agregasi Tingkat Lanjut Menggunakan .agg()
Dalam laporan komprehensif, kita sering membutuhkan ringkasan beberapa metrik statistik sekaligus untuk kolom yang berbeda. Metode .agg() memungkinkan kita menyalurkan kamus (dictionary) yang mendefinisikan operasi spesifik untuk tiap kolom:
# Agregasi multi-kolom dan multi-fungsi
laporan_kategori = df_transaksi.groupby('kategori').agg(
    total_transaksi=('transaksi_id', 'count'),
    total_unit=('kuantitas', 'sum'),
    total_pendapatan=('total_belanja', 'sum'),
    rata_rata_pendapatan=('total_belanja', 'mean')
).reset_index()

# Mengurutkan dari pendapatan tertinggi
laporan_kategori = laporan_kategori.sort_values(by='total_pendapatan', ascending=False)
print("=== Laporan Performa Kategori ===")
print(laporan_kategori)
Output:
=== Laporan Performa Kategori ===
     kategori  total_transaksi  total_unit  total_pendapatan  rata_rata_pendapatan
0  Elektronik                3           4           9300000          3.100000e+06
2   Peralatan                2           5           1550000          7.750000e+05
1     Pakaian                3          10           1500000          5.000000e+05
Sintaks penamaan baris bernama nama_kolom_baru=('kolom_asal', 'fungsi') pada .agg() menghasilkan struktur tabel yang bersih tanpa MultiIndex yang membingungkan.
4. Menggabungkan Tabel dengan pd.concat()
pd.concat() digunakan untuk menumpuk tabel secara vertikal (menambah baris) atau menyandingkan tabel secara horizontal (menambah kolom).
# Simulasi data batch transaksi tambahan bulan berikutnya
transaksi_baru = pd.DataFrame({
    'transaksi_id': [109, 110],
    'pelanggan_id': ['C05', 'C02'],
    'kategori': ['Elektronik', 'Peralatan'],
    'kota': ['Bandung', 'Surabaya'],
    'kuantitas': [1, 2],
    'total_belanja': [3200000, 600000]
})

# Menggabungkan baris secara vertikal (axis=0)
df_gabung_vertikal = pd.concat([df_transaksi, transaksi_baru], ignore_index=True)
print("Total baris setelah concat:", len(df_gabung_vertikal))
print(df_gabung_vertikal.tail(3))
Output:
Total baris setelah concat: 10
   transaksi_id pelanggan_id   kategori      kota  kuantitas  total_belanja
7           108          C03    Pakaian   Bandung          5         750000
8           109          C05 Elektronik   Bandung          1        3200000
9           110          C02  Peralatan  Surabaya          2         600000
Parameter ignore_index=True penting disematkan agar indeks baris direset secara urut dari 0 sampai tanpa menduplikasi indeks berkas asal.
5. Penggabungan Relasional dengan pd.merge()
Operasi pd.merge() serupa dengan perintah JOIN pada SQL. Metode ini mencocokkan baris antar dua DataFrame berdasarkan kolom kunci relasi (foreign key).
Mari kita buat tabel master pelanggan yang memuat tier keanggotaan dan batas kredit pelanggan:
# Tabel master profil pelanggan
df_pelanggan = pd.DataFrame({
    'pelanggan_id': ['C01', 'C02', 'C03', 'C06'],
    'nama_pelanggan': ['Budi Santoso', 'Siti Aminah', 'Rian Hidayat', 'Dewi Lestari'],
    'tier_member': ['Platinum', 'Gold', 'Silver', 'Gold']
})

print("=== Master Data Pelanggan ===")
print(df_pelanggan)
Terdapat 4 jenis operasi join yang umum digunakan pada pd.merge():
- Inner Join (
how='inner'): Hanya mengambil baris yang kuncinya cocok dan ada di kedua DataFrame. PelangganC04(hanya ada di transaksi) danC06(hanya ada di profil) akan dieliminasi. - Left Join (
how='left'): Mempertahankan seluruh baris dari DataFrame kiri (tabel transaksi). Jika pelanggan tidak ditemukan di tabel profil, kolom profil akan berisiNaN. - Right Join (
how='right'): Mempertahankan seluruh baris dari DataFrame kanan (tabel master pelanggan). - Outer Join (
how='outer'): Mempertahankan seluruh baris dari kedua tabel tanpa terkecuali.
# Contoh 1: Inner Join
inner_merged = pd.merge(df_transaksi, df_pelanggan, on='pelanggan_id', how='inner')
print("=== Inner Join (Hanya pelanggan yang terdaftar di kedua tabel) ===")
print(inner_merged[['transaksi_id', 'pelanggan_id', 'nama_pelanggan', 'tier_member', 'total_belanja']])

# Contoh 2: Left Join (Memastikan seluruh transaksi penjualan tetap tercatat)
left_merged = pd.merge(df_transaksi, df_pelanggan, on='pelanggan_id', how='left')
print("\n=== Left Join (Mempertahankan seluruh transaksi) ===")
print(left_merged[['transaksi_id', 'pelanggan_id', 'nama_pelanggan', 'tier_member', 'total_belanja']])
Output:
=== Inner Join (Hanya pelanggan yang terdaftar di kedua tabel) ===
   transaksi_id pelanggan_id nama_pelanggan tier_member  total_belanja
0           101          C01   Budi Santoso    Platinum        2500000
1           103          C01   Budi Santoso    Platinum        5000000
2           106          C01   Budi Santoso    Platinum        1200000
3           102          C02    Siti Aminah        Gold         450000
4           105          C02    Siti Aminah        Gold         300000
5           104          C03   Rian Hidayat      Silver         350000
6           108          C03   Rian Hidayat      Silver         750000

=== Left Join (Mempertahankan seluruh transaksi) ===
   transaksi_id pelanggan_id nama_pelanggan tier_member  total_belanja
0           101          C01   Budi Santoso    Platinum        2500000
1           102          C02    Siti Aminah        Gold         450000
2           103          C01   Budi Santoso    Platinum        5000000
3           104          C03   Rian Hidayat      Silver         350000
4           105          C02    Siti Aminah        Gold         300000
5           106          C01   Budi Santoso    Platinum        1200000
6           107          C04            NaN         NaN        1800000
7           108          C03   Rian Hidayat      Silver         750000
Perhatikan baris ke-6 pada hasil Left Join: Pelanggan C04 tetap muncul dalam log transaksi, namun atribut nama_pelanggan dan tier_member bernilai NaN karena datanya belum terdaftar di tabel master pelanggan.
Jika nama kolom kunci di kedua tabel berbeda (misalnya id_pelanggan di tabel kiri dan customer_code di tabel kanan), gunakan argumen left_on='id_pelanggan' dan right_on='customer_code'.
Coba sendiri
Sekarang, buka notebook Google Colab kamu dan uji pemahamanmu dengan tantangan berikut:
- Ambil DataFrame
left_mergedhasil penggabungan sebelumnya. - Lakukan pengelompokan berdasarkan dua kolom sekaligus:
['tier_member', 'kota']. - Hitunglah total transaksi dan total belanja untuk setiap kombinasi tier dan kota tersebut.
- Urutkan hasilnya berdasarkan total belanja dari yang paling besar ke yang paling kecil.
- Amatilah bagaimana data pelanggan dengan nilai
tier_memberkosong (NaN) diperlakukan oleh fungsigroupby()default!
Kesalahan yang sering terjadi
Dalam mentransformasi data, berikut adalah kekeliruan klasik yang sering dialami oleh praktisi pemula:
| Kesalahan Pemula | Penyebab Teknis | Solusi Benar |
|---|---|---|
Kehilangan data baris saat melakukan pd.merge(). |
Memakai how='inner' (default) padahal ada nilai kunci yang tidak lengkap di salah satu tabel. |
Periksa kecocokan data dengan how='left' atau how='outer', lalu cek nilai null dengan .isna().sum(). |
Muncul kolom dengan sufiks _x dan _y (misal kota_x, kota_y). |
Kedua tabel memiliki nama kolom yang identik selain kolom kunci join on. |
Spesifikasikan parameter suffixes=('_transaksi', '_profil') atau hapus kolom redundan sebelum merge. |
Hasil groupby memiliki indeks baris ganda bertingkat yang sulit diakses. |
Menjalankan agregasi tanpa menyertakan as_index=False atau tanpa .reset_index(). |
Tambahkan argumen as_index=False pada df.groupby(...) atau panggil .reset_index() setelah agregasi. |
| Duplikasi baris meledak drastis pasca penggabungan tabel (Cartesian product). | Kolom kunci pada tabel kedua bukan nilai unik (mengandung nilai duplikat many-to-many). | Pastikan tabel rujukan memiliki nilai unik pada kolom kuncinya dengan df_ref['id'].is_unique sebelum digabung. |
Nilai hilang (NaN) pada kolom pengelompokan terhapus secara otomatis. |
Parameter dropna=True aktif secara default pada groupby() sejak Pandas versi terdahulu. |
Tambahkan parameter dropna=False pada .groupby('kategori', dropna=False) jika ingin segmen null ikut dihitung. |
Kaitannya dengan Praktik Industri / AI: Dalam ekosistem rekayasa fitur (feature engineering) machine learning modern, transformasi agregasi berbasis GroupBy adalah tulang punggung pembentukan fitur tabular. Sebagai contoh, dalam sistem deteksi penipuan kartu kredit (fraud detection), model prediktif membutuhkan fitur agregasi dinamis seperti: "Berapa frekuensi transaksi akun ini dalam 24 jam terakhir?" atau "Berapa deviasi nominal transaksi saat ini terhadap rata-rata belanja historis pengguna tersebut?". Menggabungkan riwayat transaksi ke dalam profil pelanggan menggunakan
pd.merge()dan menghitung rasio deviasi statistik adalah langkah standar sebelum matriks data diserahkan ke algoritma AI.
Latihan
Selesaikan 3 soal latihan mandiri berikut menggunakan DataFrame df_transaksi dan df_pelanggan yang sudah dibuat:
- Latihan 1: Hitunglah total pendapatan dan rata-rata kuantitas pembelian yang dikelompokkan berdasarkan nama kota (
kota), lalu urutkan hasilnya dari kota dengan total pendapatan terbesar. - Latihan 2: Buatlah laporan kontribusi belanja per pelanggan dengan menggabungkan tabel
df_transaksidandf_pelangganmenggunakan Right Join. Tampilkan nama pelanggan, tier member, dan jumlah uang yang telah dibelanjakan. Pastikan pelanggan yang belum pernah bertransaksi sama sekali tetap muncul dengan nilai belanja 0! - Latihan 3: Dengan menggunakan pengelompokan multi-kolom (
['kota', 'kategori']), hitunglah nilai transaksi maksimum dan nilai transaksi minimum pada masing-masing kelompok, lalu simpan hasilnya sebagai DataFrame baru bernamadf_rentang_harga.
Kunci jawaban dan pembahasan
Mari kita bedah solusi dan logika teknis dari ketiga latihan di atas.
Solusi Latihan 1: Agregasi Berdasarkan Kota
# Mengelompokkan berdasarkan kota dengan aggregasi khusus
hasil_latihan_1 = df_transaksi.groupby('kota', as_index=False).agg(
    total_omset=('total_belanja', 'sum'),
    rata_kuantitas=('kuantitas', 'mean')
).sort_values(by='total_omset', ascending=False)

print("=== Solusi Latihan 1 ===")
print(hasil_latihan_1)
Pembahasan:
Kita menggunakan groupby('kota', as_index=False) sehingga kolom kota tetap menjadi kolom reguler. Di dalam .agg(), kita menamai kolom hasil komputasi secara deskriptif (total_omset dan rata_kuantitas). Terakhir, .sort_values(by='total_omset', ascending=False) memastikan peringkat teratas dihuni oleh kota penyumbang pendapatan tertinggi, yaitu Jakarta.
Solusi Latihan 2: Right Join dan Penanganan Nilai Kosong
# Melakukan Right Join dari master pelanggan
gabung_kanan = pd.merge(df_transaksi, df_pelanggan, on='pelanggan_id', how='right')

# Mengelompokkan berdasarkan profil pelanggan dan mengisi transaksi kosong dengan 0
laporan_belanja_member = gabung_kanan.groupby(['pelanggan_id', 'nama_pelanggan', 'tier_member'], as_index=False)['total_belanja'].sum()
laporan_belanja_member['total_belanja'] = laporan_belanja_member['total_belanja'].fillna(0)

print("\n=== Solusi Latihan 2 ===")
print(laporan_belanja_member)
Pembahasan:
Dengan menggunakan how='right', pelanggan C06 (Dewi Lestari) yang belum pernah melakukan pembelian tetap masuk ke dalam dataset gabungan. Pada saat diagregasi menggunakan .sum(), nilai transaksi Dewi yang awalnya NaN diakumulasikan menjadi 0. Metode .fillna(0) disematkan sebagai perlindungan tambahan agar data siap dipakai untuk pelaporan keuangan tanpa menghasilkan nilai kosong.
Solusi Latihan 3: Pengelompokan Multi-Kolom
# Pengelompokan berjenjang kota dan kategori
df_rentang_harga = df_transaksi.groupby(['kota', 'kategori'], as_index=False).agg(
    harga_min=('total_belanja', 'min'),
    harga_max=('total_belanja', 'max')
)

print("\n=== Solusi Latihan 3 ===")
print(df_rentang_harga)
Pembahasan:
Ketika kita memberikan list kolom ['kota', 'kategori'] pada groupby(), Pandas akan memecah data menjadi kombinasi unik antar kedua atribut tersebut (misalnya Jakarta-Elektronik, Jakarta-Peralatan, Bandung-Peralatan, dst.). Argumen agregasi 'min' dan 'max' mencari nilai transaksi terendah dan tertinggi pada masing-masing kelompok data tersebut.


Diskusi (0)
Kami menyimpan nama (opsional), komentar, dan hash teknis (bukan alamat IP asli) untuk mencegah spam. Cookie fungsional dipakai agar Anda dapat mengedit atau menghapus komentar sendiri dari browser ini. Untuk permintaan penghapusan, gunakan halaman kontak.
Belum ada komentar. Mulai diskusinya.