Data Science
Feature Engineering: Encoding Kategori dan Penskalaan Fitur
Tingkatkan performa model machine learning dengan feature engineering: teknik encoding data kategori (One-Hot dan Label Encoding), penskalaan fitur numerik, serta strategi mencegah kebocoran data (data leakage).
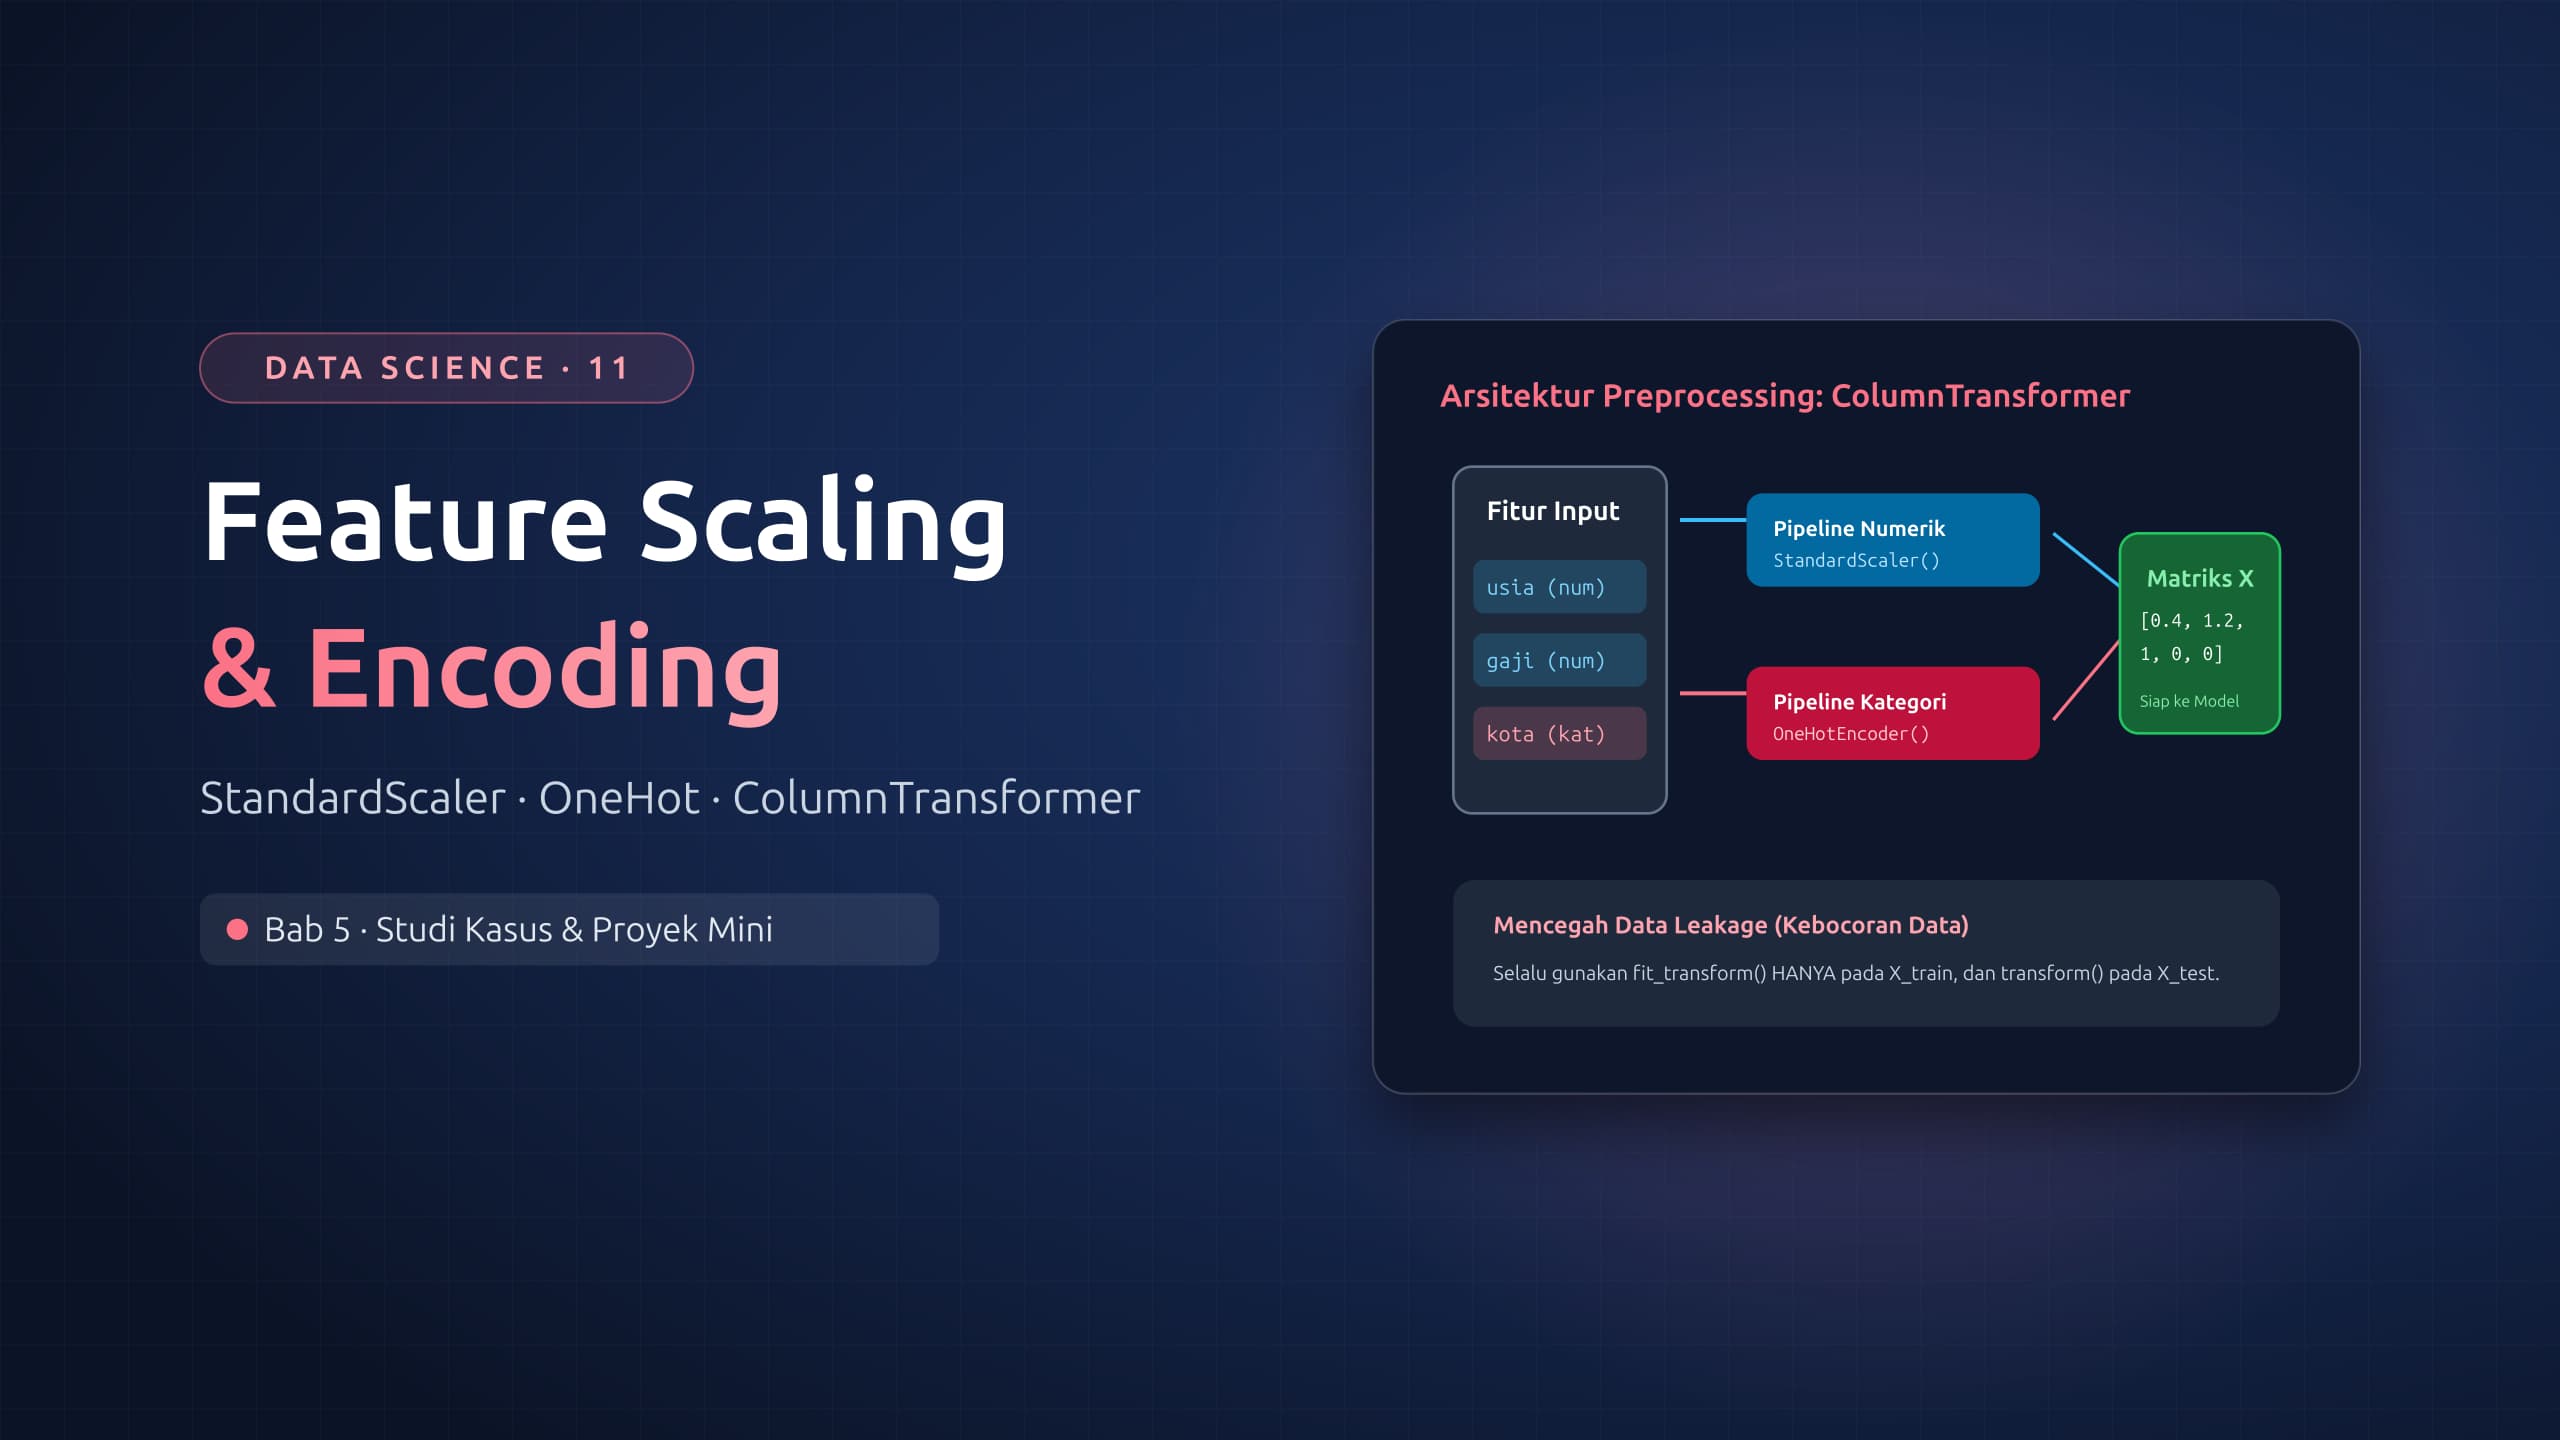
Bayangkan sebuah perusahaan teknologi transportasi online ingin memprediksi tarif perjalanan dan estimasi kedatangan armada (estimated time of arrival). Dataset operasional yang dikumpulkan setiap detik merekam variabel dalam berbagai rupa: kolom teks kategori seperti kota operasional (Jakarta, Surabaya, Bandung), tipe layanan armada (Motor, Mobil Hemat, Mobil Premium), status cuaca (Cerah, Hujan Ringan, Badai), serta fitur-fitur numerik yang memiliki rentang angka yang sangat timpang—misalnya jarak perjalanan dalam satuan kilometer (rentang 1 hingga 40 km) bersanding dengan nominal argo dasar (rentang puluhan ribu hingga ratusan ribu rupiah). Algoritma Machine Learning pada prinsipnya adalah mesin aljabar linier murni yang hanya mampu memproses matriks numerik terstandarisasi. Jika Anda langsung menyodorkan teks mentah atau membiarkan angka berskala ratusan ribu bercampur dengan angka satuan, kalkulasi gradien model akan terdistorsi dan performa prediksinya hancur. Tahap krusial untuk mentransformasi, menyelaraskan, dan mengekstrak representasi terbaik dari data mentah ini dinamakan Feature Engineering.
Yang akan dipelajari
Dalam artikel ini, Anda akan mempelajari teknik rekayasa fitur data tabular yang esensial:
- Memahami urgensi Feature Engineering dalam meningkatkan kapasitas prediktif model.
- Mengubah variabel teks kategori berurutan (ordinal) menggunakan teknik Ordinal Mapping dan Label Encoding.
- Mengonversi data kategori tanpa urutan (nominal) menjadi representasi biner menggunakan One-Hot Encoding.
- Membandingkan prinsip kerja serta perbedaan hasil penskalaan fitur numerik antara Standardisasi (
StandardScaler) dan Normalisasi (MinMaxScaler). - Memahami ancaman bahaya kebocoran data (data leakage) dan cara mutlak mencegahnya dalam alur pra-pemrosesan data.
- Mengombinasikan transformasi fitur numerik dan kategorikal secara rapi menggunakan
ColumnTransformer.
Encoding: Mengubah Teks Kategori Menjadi Angka
Data kategori pada tabel umumnya terbagi menjadi dua jenis dengan karakteristik yang berbeda secara fundamental:
1. Kategori Ordinal (Memiliki Tingkatan / Hierarki Alami)
Kategori ordinal memiliki urutan inheren yang bermakna. Contohnya adalah tingkat kepuasan pelanggan (Kurang, Cukup, Puas, Sangat Puas) atau tingkat kepadatan lalu lintas (Rendah, Sedang, Tinggi).
Untuk kategori ordinal, kita harus mempertahankan urutan hierarki tersebut dengan memetakannya ke integer berurutan menggunakan kamus (dictionary mapping) atau OrdinalEncoder:
import pandas as pd

df_layanan = pd.DataFrame({
    "id_pelanggan": [101, 102, 103, 104],
    "tipe_keanggotaan": ["Bronze", "Gold", "Silver", "Platinum"]
})

# Menentukan urutan hierarki tingkatan secara eksplisit
peta_tier = {
    "Bronze": 1,
    "Silver": 2,
    "Gold": 3,
    "Platinum": 4
}

df_layanan["tier_encoded"] = df_layanan["tipe_keanggotaan"].map(peta_tier)
print(df_layanan)

# Output:
#    id_pelanggan tipe_keanggotaan  tier_encoded
# 0           101            Bronze             1
# 1           102              Gold             3
# 2           103            Silver             2
# 3           104          Platinum             4
2. Kategori Nominal (Tanpa Urutan / Hierarki)
Kategori nominal tidak memiliki hubungan matematis lebih tinggi atau lebih rendah. Contohnya adalah nama kota asal (Bandung, Jakarta, Surabaya) atau metode pembayaran (Tunai, E-Wallet, Kartu Kredit).
Jika Anda menggunakan integer bertahap (Bandung = 0, Jakarta = 1, Surabaya = 2), algoritma regresi linier atau jaringan saraf tiruan secara keliru akan menganggap bahwa Surabaya dua kali lebih bernilai dibanding Jakarta, atau Bandung lebih rendah daripada Surabaya. Ini adalah bias asumsi palsu (false numerical hierarchy).
Solusi tepat untuk kategori nominal adalah One-Hot Encoding. Setiap nilai unik kategori diubah menjadi kolom biner baru bernilai 1 jika data cocok dan 0 jika sebaliknya:
import pandas as pd
from sklearn.preprocessing import OneHotEncoder

df_armada = pd.DataFrame({
    "kota": ["Jakarta", "Surabaya", "Bandung", "Jakarta"],
    "layanan": ["Motor", "Mobil", "Mobil", "Motor"]
})

# Cara 1: Menggunakan fungsi instan bawaan Pandas (pd.get_dummies)
df_dummies = pd.get_dummies(df_armada, columns=["kota", "layanan"], dtype=int)
print("One-Hot Encoding dengan Pandas get_dummies:")
print(df_dummies)

# Cara 2: Menggunakan OneHotEncoder Scikit-Learn (Direkomendasikan untuk pipeline produksi)
ohe = OneHotEncoder(sparse_output=False, handle_unknown="ignore")
array_encoded = ohe.fit_transform(df_armada[["kota", "layanan"]])
nama_kolom = ohe.get_feature_names_out(["kota", "layanan"])

df_ohe_sklearn = pd.DataFrame(array_encoded, columns=nama_kolom, dtype=int)
print("\nOne-Hot Encoding dengan Scikit-Learn:")
print(df_ohe_sklearn)

# Output:
# One-Hot Encoding dengan Pandas get_dummies:
#    kota_Bandung  kota_Jakarta  kota_Surabaya  layanan_Mobil  layanan_Motor
# 0             0             1              0              0              1
# 1             0             0              1              1              0
# 2             1             0              0              1              0
# 3             0             1              0              0              1
#
# One-Hot Encoding dengan Scikit-Learn:
#    kota_Bandung  kota_Jakarta  kota_Surabaya  layanan_Mobil  layanan_Motor
# 0             0             1              0              0              1
# 1             0             0              1              1              0
# 2             1             0              0              1              0
# 3             0             1              0              0              1
Catatan: Parameter handle_unknown='ignore' pada Scikit-Learn sangat penting karena menjamin sistem tidak akan macet jika di kemudian hari muncul data uji dengan nilai kategori baru (misalnya kota Yogyakarta).
Penskalaan Fitur Numerik (Feature Scaling)
Mengapa fitur numerik perlu disetarakan skalanya?
Pertimbangkan dua fitur: Usia nasabah (rentang 20 sampai 65 tahun) dan Gaji bulanan (rentang Rp5.000.000 hingga Rp50.000.000). Sebagian besar algoritma machine learning (seperti K-Nearest Neighbors, Support Vector Machine, Regresi Linier Ter-regularisasi, dan Neural Networks) menghitung jarak geometris (Euclidean distance) atau turunan gradien (gradient descent). Karena nilai selisih gaji bernilai jutaan sementara usia bernilai puluhan, kalkulasi matematika model akan sepenuhnya didominasi oleh fitur gaji semata, mengabaikan signifikansi fitur usia.
Dua metode penskalaan utama di Scikit-Learn adalah:
1. Standardisasi (StandardScaler)
Standardisasi mentransformasikan sebaran fitur sehingga memiliki nilai rata-rata (mean) dan simpangan baku (standard deviation) melalui rumus Z-score:
Standardisasi tidak membatasi rentang nilai ke batas tetap tertentu dan sangat tangguh terhadap dataset yang mengandung pencilan (outliers).
2. Normalisasi Min-Max (MinMaxScaler)
Normalisasi mengompresi seluruh rentang nilai data asli agar masuk tepat ke dalam interval :
MinMaxScaler sangat ideal saat Anda mengetahui secara pasti batas batas atas dan bawah data, atau untuk algoritma yang mensyaratkan bobot non-negatif.
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler, MinMaxScaler

data_karyawan = pd.DataFrame({
    "usia": [22, 28, 35, 45, 58],
    "gaji_juta": [5.0, 8.5, 15.0, 25.0, 50.0]
})

# Menerapkan StandardScaler
std_scaler = StandardScaler()
data_std = std_scaler.fit_transform(data_karyawan)
df_std = pd.DataFrame(data_std, columns=["usia_std", "gaji_std"])

# Menerapkan MinMaxScaler
minmax_scaler = MinMaxScaler()
data_minmax = minmax_scaler.fit_transform(data_karyawan)
df_minmax = pd.DataFrame(data_minmax, columns=["usia_minmax", "gaji_minmax"])

print("Data Asli:")
print(data_karyawan)
print("\nHasil Standardisasi (mean=0, std=1):")
print(df_std.round(3))
print("\nHasil Min-Max Scaling (rentang 0 sampai 1):")
print(df_minmax.round(3))

# Output:
# Data Asli:
#    usia  gaji_juta
# 0    22        5.0
# 1    28        8.5
# 2    35       15.0
# 3    45       25.0
# 4    58       50.0
#
# Hasil Standardisasi (mean=0, std=1):
#    usia_std  gaji_std
# 0    -1.189    -0.999
# 1    -0.729    -0.781
# 2    -0.192    -0.375
# 3     0.575     0.250
# 4     1.534     1.905
#
# Hasil Min-Max Scaling (rentang 0 sampai 1):
#    usia_minmax  gaji_minmax
# 0        0.000        0.000
# 1        0.167        0.078
# 2        0.361        0.222
# 3        0.639        0.444
# 4        1.000        1.000
Menghindari Kebocoran Data (Data Leakage)
Salah satu dosa terbesar yang sering dilakukan oleh praktisi machine learning pemula adalah Data Leakage (kebocoran informasi data uji ke dalam proses pelatihan).
Aturan baku yang tidak boleh dilanggar:
Parameter transformasi () HANYA boleh dipelajari dari DATA LATIH (
fitpada data train). Jangan pernah melibatkan data uji saat proses penghitungan statistik tersebut!
Jika Anda memanggil scaler.fit_transform(X) pada seluruh dataset sebelum melakukan train_test_split(), informasi distribusi rata-rata dan rentang nilai dari data uji telah merembes masuk ke dalam proses pengolahan data latih. Akibatnya, skor evaluasi model pada tahap validasi akan tampak impresif secara artifisial, namun performanya langsung ambruk saat berhadapan dengan data transaksi nyata di server produksi.
Pola kode yang benar:
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

X = data_karyawan[["usia", "gaji_juta"]]
y = np.array([0, 0, 1, 1, 1])

# 1. Pisahkan train dan test terlebih dahulu!
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.4, random_state=42)

scaler = StandardScaler()

# 2. FIT HANYA pada data latih, lalu TRANSFORM data latih
X_train_scaled = scaler.fit_transform(X_train)

# 3. Pada data uji, HANYA panggil TRANSFORM (JANGAN panggil fit!)
X_test_scaled = scaler.transform(X_test)
Memadukan Alur dengan ColumnTransformer
Dalam dataset nyata, kita memiliki kolom numerik dan kolom teks secara bersamaan. Alih-alih melakukan pemisahan manual yang merepotkan dan rawan salah, Scikit-Learn menyediakan alat otomatis bernama ColumnTransformer:
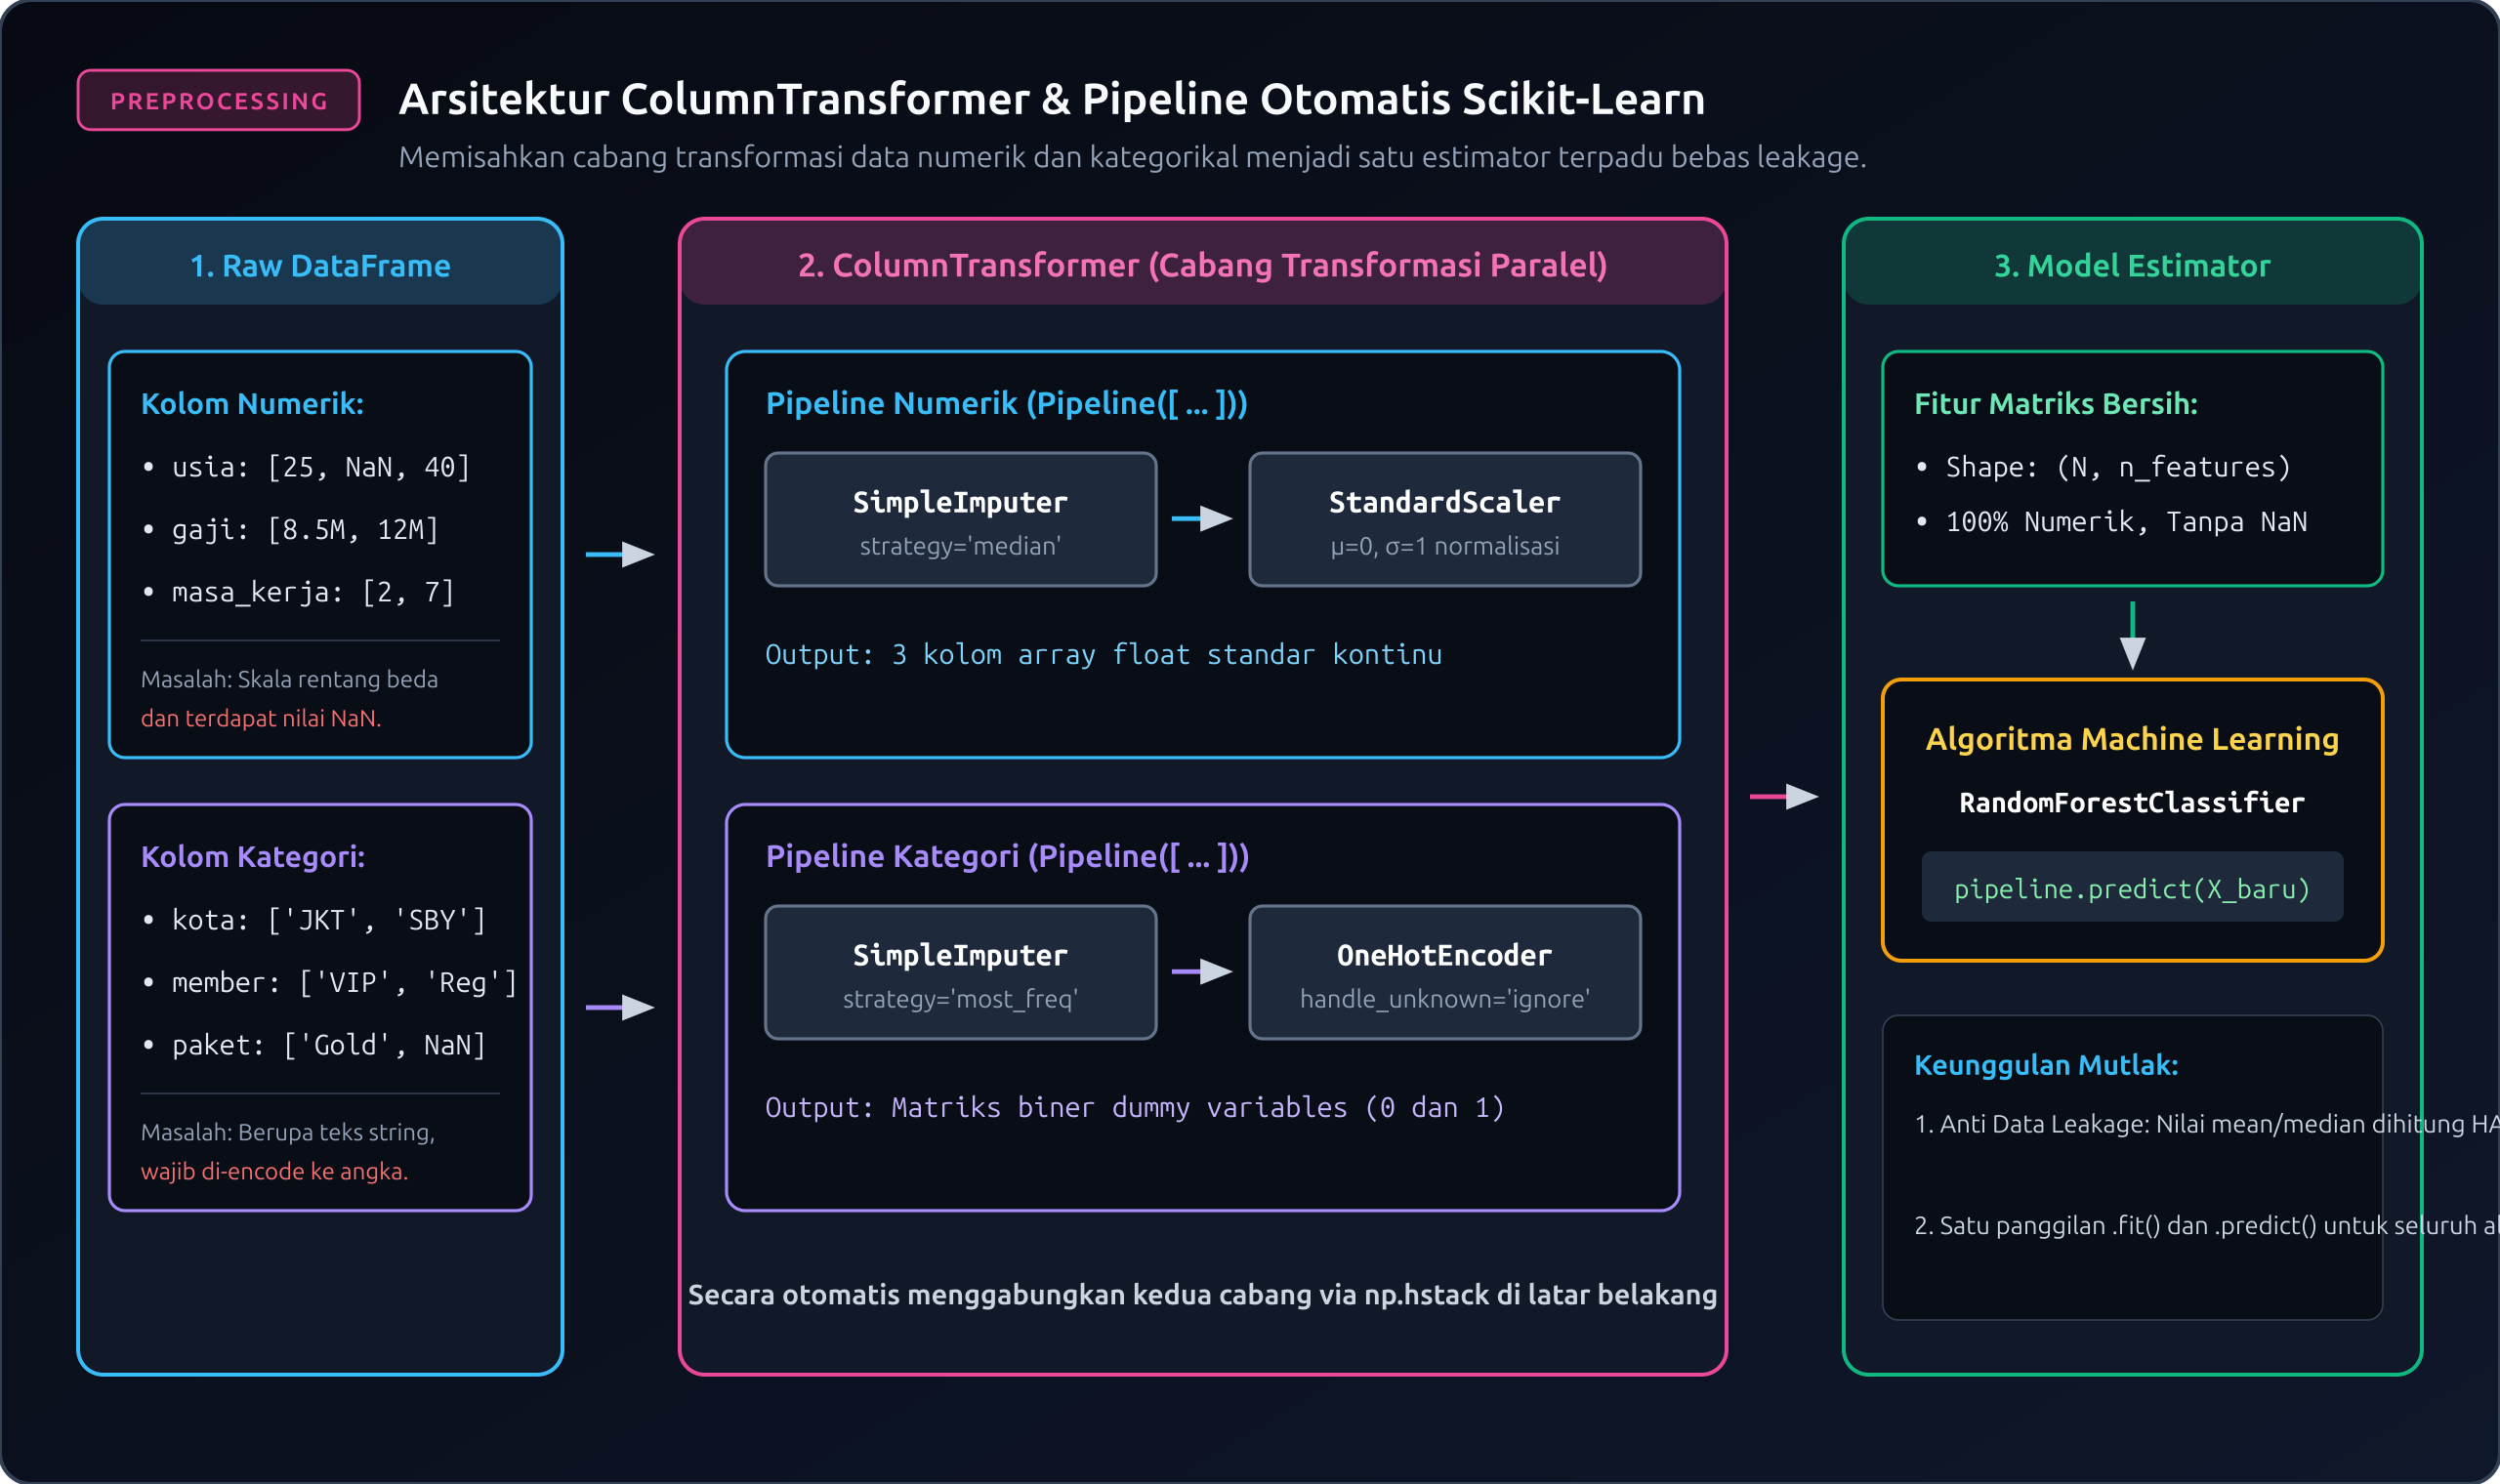
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder

df_transaksi = pd.DataFrame({
    "umur": [25, 40, 32, 48],
    "pengeluaran_juta": [1.5, 8.2, 4.0, 12.5],
    "tipe_member": ["Reguler", "VIP", "Reguler", "VIP"],
    "wilayah": ["Barat", "Timur", "Pusat", "Barat"]
})

kolom_numerik = ["umur", "pengeluaran_juta"]
kolom_kategori = ["tipe_member", "wilayah"]

# Membangun transformer gabungan
preprocessor = ColumnTransformer(
    transformers=[
        ("num", StandardScaler(), kolom_numerik),
        ("cat", OneHotEncoder(sparse_output=False), kolom_kategori)
    ]
)

# Menjalankan pemrosesan pada data
hasil_proses = preprocessor.fit_transform(df_transaksi)
kolom_baru = preprocessor.get_feature_names_out()

df_siap_model = pd.DataFrame(hasil_proses, columns=kolom_baru)
print("Dataset Siap Model ML:")
print(df_siap_model.round(2))

# Output:
# Dataset Siap Model ML:
#    num__umur  num__pengeluaran_juta  cat__tipe_member_Reguler  ...  cat__wilayah_Timur
# 0      -1.33                  -1.22                       1.0  ...                 0.0
# 1       0.44                   0.39                       0.0  ...                 1.0
# 2      -0.52                  -0.62                       1.0  ...                 0.0
# 3       1.41                   1.44                       0.0  ...                 0.0
Coba sendiri
Lakukan eksperimen interaktif ini di Google Colab:
- Buat DataFrame baru yang memiliki kolom teks kategori
kotadengan nilai["Jakarta", "Bandung", "Surabaya"]dan kolom numeriksuhudengan nilai[32.5, 24.0, 35.0]. - Latih
StandardScalerhanya pada kolomsuhudata tersebut. - Periksa nilai rata-rata (
scaler.mean_) dan simpangan baku (scaler.scale_) yang dihitung oleh scaler. - Transformasikan data suhu ekstrem baru
[45.0]menggunakan metode.transform([[45.0]])dan perhatikan bagaimana nilai z-score hasil transformasi berada di atas .
# Coba di notebook Colab Anda:
import pandas as pd
from sklearn.preprocessing import StandardScaler

scaler_suhu = StandardScaler()
data_suhu = pd.DataFrame({"suhu": [32.5, 24.0, 35.0]})
scaler_suhu.fit(data_suhu[["suhu"]])

print("Nilai Mean yang dipelajari   :", scaler_suhu.mean_[0])
print("Transformasi suhu 45 derajat :", scaler_suhu.transform([[45.0]])[0][0])
Kesalahan yang sering terjadi
Berikut rangkuman kesalahan klasik saat menangani feature engineering beserta cara pencegahannya:
| Kesalahan Pemula | Gejala / Pesan Kesalahan | Penyebab Utama | Solusi yang Tepat |
|---|---|---|---|
Memanggil .fit() atau .fit_transform() pada data uji |
Performa model di pengujian tampak fantastis namun gagal di produksi | Terjadi data leakage karena data uji mencemari statistik data latih. | Panggil .fit_transform() HANYA pada X_train, dan panggil .transform() pada X_test. |
| Menggunakan Label Encoding untuk kategori nominal acak | Model regresi mengasumsikan relasi linear artifisial antar kategori | Menetapkan urutan angka ordinal pada variabel tanpa tingkatan nyata. | Gunakan One-Hot Encoding (OneHotEncoder / pd.get_dummies) untuk kategori non-hierarkis. |
| Crash saat data uji mengandung kategori baru | ValueError: Found unknown categories... |
Terdapat nilai teks baru pada data uji yang tidak ada pada data latih. | Pasang parameter handle_unknown='ignore' saat menginisialisasi OneHotEncoder. |
| Melakukan scale pada kolom label target klasifikasi | Nilai target diskrit 0 dan 1 berubah menjadi float desimal |
Menerapkan scaler secara membabi buta pada matriks dan vektor target . | Penskalaan fitur hanya dilakukan pada variabel prediktor (), bukan pada target diskrit (). |
Kaitannya dengan Praktik Industri / AI: Dalam ekosistem rekayasa data modern, terdapat adagium terkenal: "Better data beats better algorithms". Sering kali, lompatan terbesar pada akurasi sistem kecerdasan buatan komersial di industri tidak didapat dari mengganti algoritma machine learning, melainkan dari kreativitas melakukan feature engineering—seperti mengekstrak komponen jam dan hari libur dari data timestamp transaksi, atau merekayasa rasio interaksi pengguna. Pada bidang deep learning modern untuk Natural Language Processing (NLP), konsep representasi vektor word embeddings (seperti Word2Vec hingga transformer OpenAI) pada hakikatnya adalah evolusi canggih dari konsep encoding representasi data kategori berdimensi tinggi.
Latihan
Uji kemahiran Anda dalam pemrosesan dan penskalaan data dengan menyelesaikan 3 soal latihan berikut:
- Soal 1: Sebuah platform e-commerce memiliki daftar rating ulasan produk bertipe teks ordinal:
["Buruk", "Cukup", "Bagus", "Sangat Bagus", "Bagus"]. Buat skrip Python menggunakan dictionary mapping Pandas untuk mengubah data teks tersebut menjadi angka integer berskala 1 sampai 4 secara berurutan. - Soal 2: Diberikan array data jarak tempuh armada kurir (dalam km):
[5.0, 12.0, 8.5, 25.0, 40.0]. TerapkanMinMaxScalerdari Scikit-Learn untuk menormalkan data jarak tersebut ke rentang . Cetak array hasil transformasinya. - Soal 3: Sebuah tim analis membagi data transaksi menjadi 8 data latih dan 2 data uji. Terapkan
StandardScalerdengan pola bebas kebocoran data (zero data leakage): hitung mean dan deviasi standar hanya dari data latih, lalu lakukan transformasi pada kedua set data. Tampilkan nilai rata-rata dari data latih yang telah terstandardisasi.
Kunci jawaban dan pembahasan
Solusi Soal 1
import pandas as pd

# Data ulasan produk
df_ulasan = pd.DataFrame({
    "ulasan": ["Buruk", "Cukup", "Bagus", "Sangat Bagus", "Bagus"]
})

# Kamus pemetaan ordinal 1-4
peta_rating = {
    "Buruk": 1,
    "Cukup": 2,
    "Bagus": 3,
    "Sangat Bagus": 4
}

df_ulasan["skor_rating"] = df_ulasan["ulasan"].map(peta_rating)

print("Hasil Ordinal Mapping:")
print(df_ulasan)

# Output:
# Hasil Ordinal Mapping:
#          ulasan  skor_rating
# 0         Buruk            1
# 1         Cukup            2
# 2         Bagus            3
# 3  Sangat Bagus            4
# 4         Bagus            3
Pembahasan: Karena data ulasan memiliki tingkatan mutu alami dari yang terendah ke tertinggi, metode ordinal mapping menggunakan .map() mempertahankan hierarki tingkatan tersebut secara logis ke dalam format angka integer .
Solusi Soal 2
import numpy as np
from sklearn.preprocessing import MinMaxScaler

# Menyiapkan array jarak (diubah menjadi bentuk 2D n_samples, 1)
jarak_km = np.array([5.0, 12.0, 8.5, 25.0, 40.0]).reshape(-1, 1)

scaler = MinMaxScaler()
jarak_scaled = scaler.fit_transform(jarak_km)

print("Array jarak asli (km):\n", jarak_km.ravel())
print("\nArray jarak setelah MinMaxScaler (rentang 0-1):\n", jarak_scaled.ravel())

# Output:
# Array jarak asli (km):
#  [ 5.  12.   8.5 25.  40. ]
#
# Array jarak setelah MinMaxScaler (rentang 0-1):
#  [0.   0.2  0.1  0.57142857 1.  ]
Pembahasan: Nilai minimum () berubah menjadi , sedangkan nilai maksimum () dipetakan menjadi . Nilai perantara lainnya diproporsikan secara seragam sesuai rumus .
Solusi Soal 3
import numpy as np
from sklearn.preprocessing import StandardScaler

# Data latih (8 sampel) dan data uji (2 sampel)
train_gaji = np.array([[4.5], [5.0], [6.2], [7.0], [5.8], [6.5], [8.0], [5.5]])
test_gaji = np.array([[6.0], [9.5]])

scaler = StandardScaler()

# 1. Fit dan transform HANYA pada data latih
train_scaled = scaler.fit_transform(train_gaji)

# 2. HANYA transform pada data uji menggunakan statistik data latih
test_scaled = scaler.transform(test_gaji)

print("Nilai mean data latih yang dipelajari :", scaler.mean_[0])
print("Rata-rata hasil scale data latih      :", np.round(train_scaled.mean(), 6))
print("Hasil scale data uji                  :\n", test_scaled)

# Output:
# Nilai mean data latih yang dipelajari : 6.0625
# Rata-rata hasil scale data latih      : -0.0
# Hasil scale data uji                  :
#  [[-0.06385202]
#  [ 3.51186088]]
Pembahasan: Rata-rata hasil standardisasi data latih tepat bernilai . Data uji ditransformasikan menggunakan nilai milik data latih tanpa menghitung ulang rata-rata data uji, sehingga integritas pengujian terjaga dan bebas dari kebocoran data.


Diskusi (0)
Kami menyimpan nama (opsional), komentar, dan hash teknis (bukan alamat IP asli) untuk mencegah spam. Cookie fungsional dipakai agar Anda dapat mengedit atau menghapus komentar sendiri dari browser ini. Untuk permintaan penghapusan, gunakan halaman kontak.
Belum ada komentar. Mulai diskusinya.