Data Science
Konsep Dasar Machine Learning & Alur Kerja Scikit-Learn
Pahami fondasi Machine Learning modern dan alur kerja Scikit-Learn. Pelajari taksonomi ML, pemisahan fitur X dan target y, pembagian train-test split, serta pola desain API fit, predict, dan score.
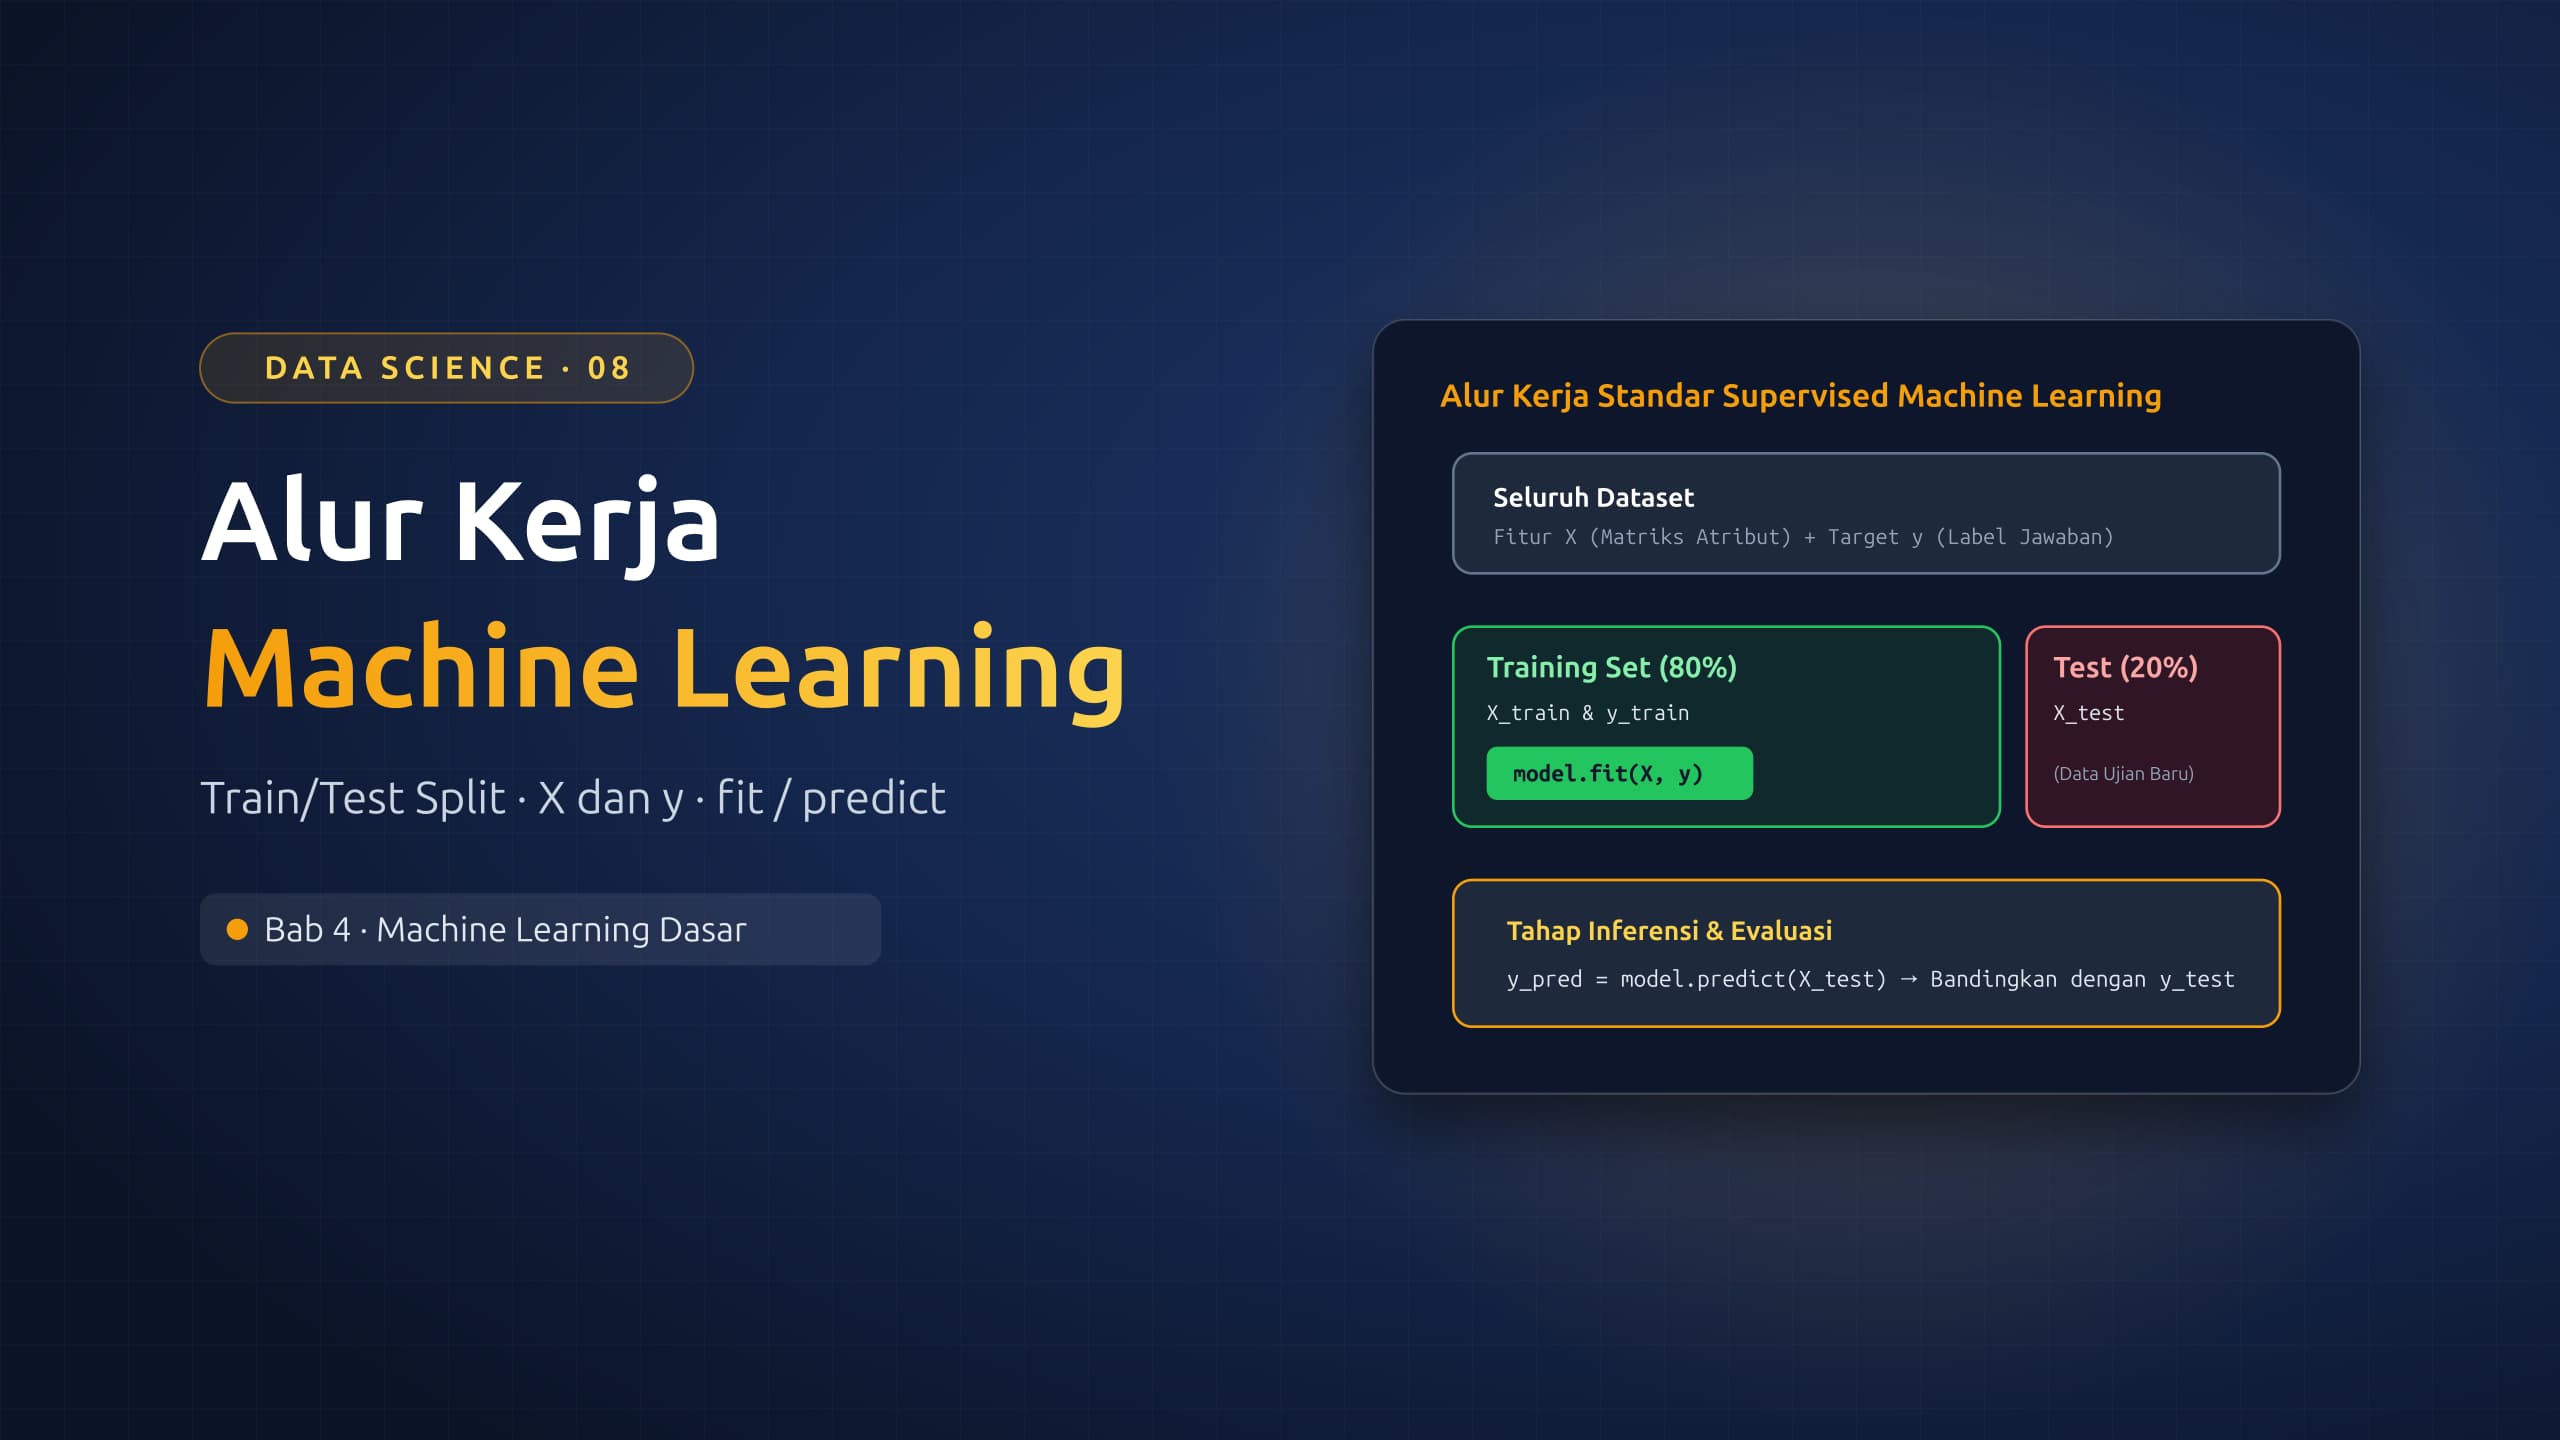
Dalam pemrograman tradisional berbasis aturan (rule-based programming), seorang pengembang perangkat lunak menuliskan aturan logika secara eksplisit (seperti serangkaian pernyataan if-else yang rumit) untuk mengolah data masukan menjadi keluaran tertentu. Namun, bagaimana jika aturan tersebut mustahil dirumuskan secara manual? Sebagai contoh: bagaimana aturan pasti untuk mendeteksi transaksi kartu kredit penipuan (fraud), membedakan email spam dari email primer, atau memprediksi harga rumah di masa depan berdasarkan puluhan variabel lokasi dan fasilitas?
Di sinilah paradigma Machine Learning (ML) mengambil alih. Alih-alih manusia yang menuliskan aturan, kita memberikan ribuan contoh data masa lalu beserta hasil keputusannya kepada algoritma komputer. Algoritma tersebut secara mandiri mempelajari pola matematis dari data tersebut dan merumuskan model prediktif untuk mengambil keputusan pada data baru yang belum pernah dilihat sebelumnya.
Dalam ekosistem Python, Scikit-Learn (sklearn) adalah pustaka de facto standar industri untuk membangun model Machine Learning klasik. Berkat arsitektur antarmuka (API design) yang sangat konsisten, memelajari alur kerja satu model di Scikit-Learn akan langsung membuka pintu untuk memahami ratusan algoritma lainnya.
Yang akan dipelajari
Dalam materi pengantar ini, kamu akan menguasai:
- Taksonomi dasar Machine Learning: perbedaan prinsipil antara Supervised Learning, Unsupervised Learning, dan Reinforcement Learning.
- Anatomi data pemodelan: memisahkan matriks fitur independen () dan vektor target terikat ().
- Alasan mendasar perlunya pemisahan data latih dan data uji (Train/Test Split) untuk mengukur kemampuan generalisasi.
- Implementasi fungsi
train_test_splitdari pustakasklearn.model_selection. - Pola perancangan terpadu API Scikit-Learn: siklus Instansiasi,
.fit(),.predict(), dan.score().
Konsep dan Intuisi: Taksonomi & Alur Kerja ML
Secara umum, Machine Learning dikelompokkan ke dalam tiga rumpun besar:
- Supervised Learning (Pembelajaran Terawasi): Model dilatih menggunakan data yang sudah memiliki label jawaban yang benar (ground truth). Tujuannya adalah memetakan hubungan fungsi antara variabel input dengan variabel output .
- Regresi: Jika label target berupa nilai kontinu numerik (misal: memprediksi harga rumah, estimasi gaji, perkiraan suhu).
- Klasifikasi: Jika label target berupa kategori diskret (misal: diagnosis sakit/sehat, deteksi spam/bukan spam, klasifikasi gambar kucing/anjing).
- Unsupervised Learning (Pembelajaran Tak Terawasi): Model diberikan data tanpa label target. Tugas model adalah menemukan pola tersembunyi, struktur alami, atau pengelompokan kemiripan (seperti segmentasi klaster pelanggan dengan K-Means atau reduksi dimensi dengan PCA).
- Reinforcement Learning (Pembelajaran Penguatan): Agen pintar belajar mengambil urutan tindakan dalam lingkungan (environment) dinamis melalui mekanisme penghargaan (reward) dan hukuman (penalty), seperti AI bermain catur atau kendali navigasi robot otonom.
Berikut skema komparasi pemrograman klasik vs paradigma Machine Learning:
Pemrograman Tradisional:
  [Data]   + [Aturan / Logika Manual] --------> [Hasil / Keputusan]

Machine Learning (Supervised):
  [Data Input (X)] + [Jawaban Masa Lalu (y)] -> [Proses Latih] -> [Model / Aturan AI]

Tahap Prediksi Data Baru:
  [Data Baru (X_test)] ------------------------> [Model AI] ------> [Prediksi (y_pred)]
Mengapa Harus Ada Train/Test Split?
Jika seorang siswa diberikan 50 soal ujian latihan lengkap dengan kunci jawabannya selama seminggu penuh, lalu pada hari ujian ia diuji dengan 50 soal yang persis sama, siswa tersebut bisa mendapatkan nilai 100 hanya dengan menghafal (memorization), bukan karena ia benar-benar paham konsepnya.
Dalam Machine Learning, fenomena menghafal data latihan ini disebut Overfitting. Model yang mengalami overfitting terlihat sempurna saat mengolah data latih, namun langsung gagal total (performa anjlok) saat menghadapi data nyata di dunia produksi.
Untuk mencegah ilusi evaluasi ini, kita wajib membagi dataset menjadi dua porsi independen:
- Data Latih (Training Set): Digunakan algoritma untuk mempelajari pola data (biasanya 70% – 80% dari total data).
- Data Uji (Testing Set): Disembunyikan sepenuhnya selama proses pelatihan, dan hanya dikeluarkan pada akhir tahap untuk menguji kemampuan generalisasi model terhadap data baru (biasanya 20% – 30% dari total data).
Praktik Kode Bertahap
Mari kita gunakan dataset klasik yang sangat terkenal di dunia data science: Dataset Bunga Iris (disediakan langsung oleh Scikit-Learn) untuk mempraktikkan alur kerja standar ini dari hulu ke hilir.
1. Memuat Dataset dan Mengekstrak Matriks Fitur () serta Target ()
import numpy as np
import pandas as pd
from sklearn.datasets import load_iris

# Memuat dataset bunga Iris bawaan scikit-learn
iris = load_iris(as_frame=True)
df_iris = iris.frame

print("=== 5 Baris Pertama Dataset Iris ===")
print(df_iris.head())
print("\nDimensi dataset:", df_iris.shape)
print("Nama kelas target:", iris.target_names)
Output:
=== 5 Baris Pertama Dataset Iris ===
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target
0                5.1               3.5                1.4               0.2       0
1                4.9               3.0                1.4               0.2       0
2                4.7               3.2                1.3               0.2       0
3                4.6               3.1                1.5               0.2       0
4                5.0               3.6                1.4               0.2       0

Dimensi dataset: (150, 5)
Nama kelas target: ['setosa' 'versicolor' 'virginica']
Dalam notasi matematika standar Scikit-Learn:
- ditulis dengan huruf kapital karena berupa matriks 2 dimensi (tabel dengan baris observasi dan kolom fitur).
- ditulis dengan huruf kecil karena berupa vektor 1 dimensi (larik berisi label target).
# Memisahkan matriks fitur (X) dan vektor target (y)
X = df_iris.drop(columns=['target'])
y = df_iris['target']

print("Bentuk matriks X:", X.shape)
print("Bentuk vektor y :", y.shape)
Output:
Bentuk matriks X: (150, 4)
Bentuk vektor y : (150,)
2. Membagi Data: Data Latih dan Data Uji (Train-Test Split)
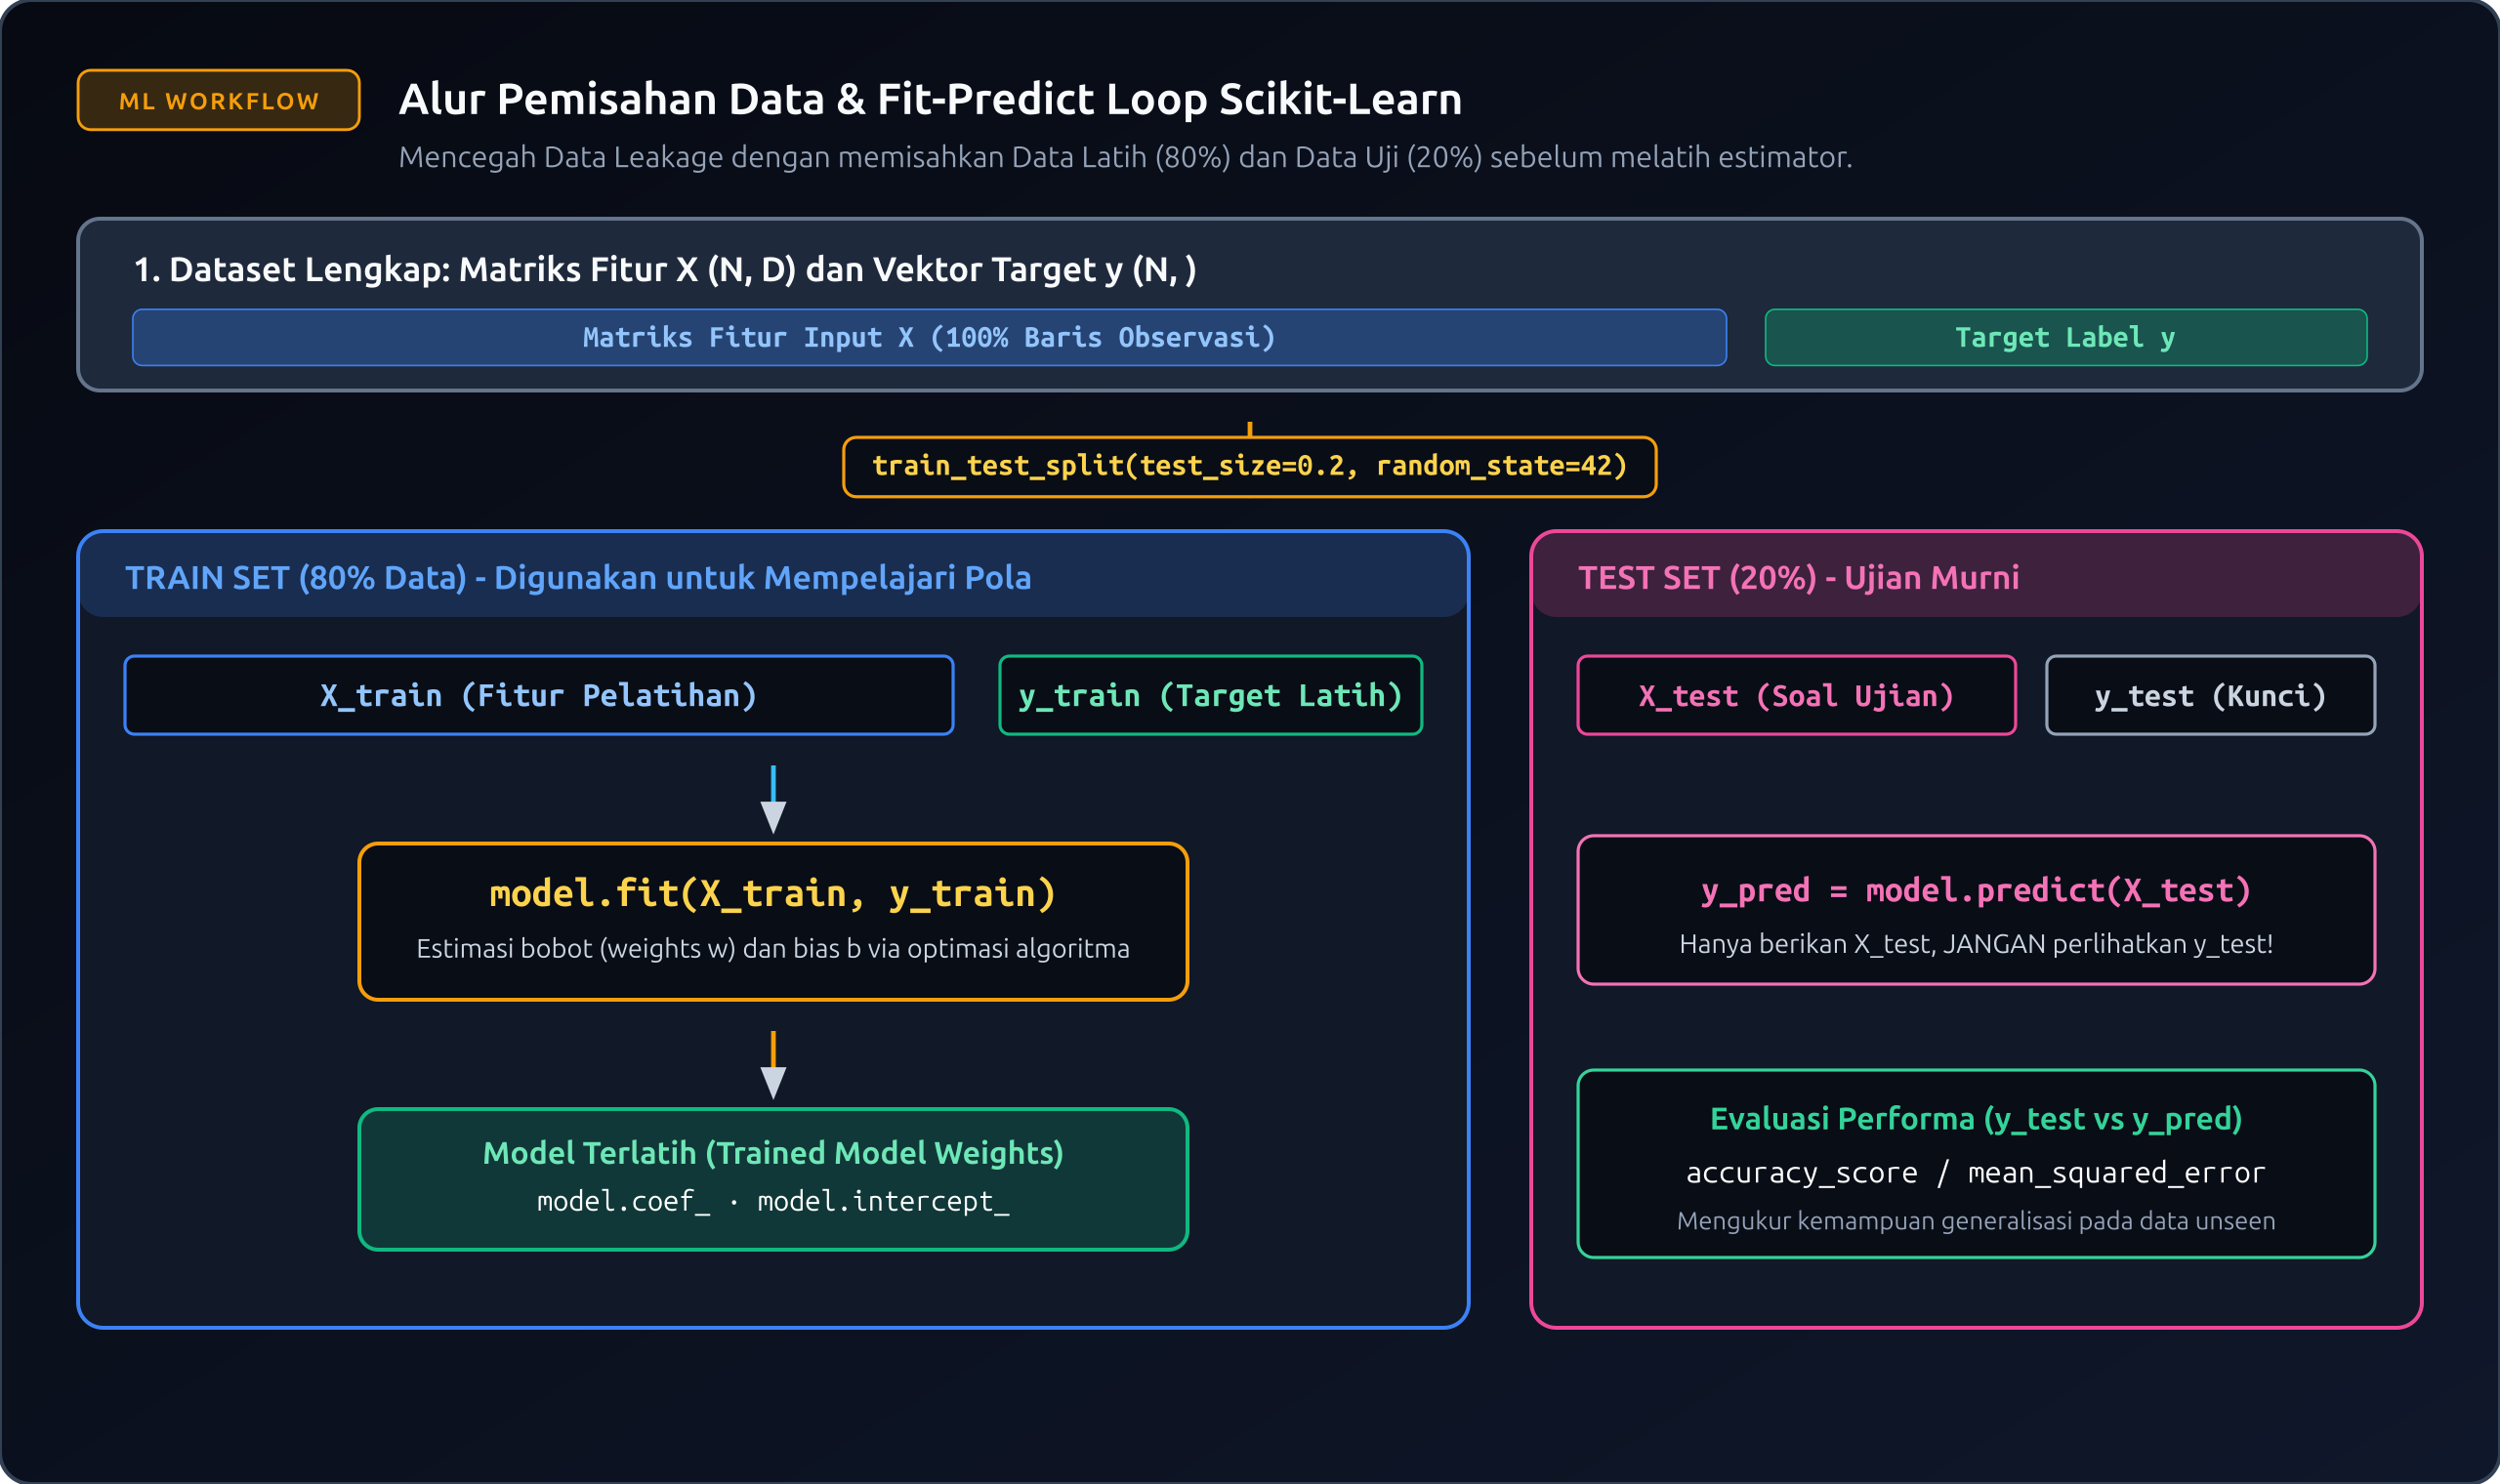
Scikit-Learn menyediakan fungsi train_test_split dalam modul sklearn.model_selection. Tiga parameter krusial yang perlu diperhatikan:
test_size=0.2: Mengalokasikan 20% data (30 baris) sebagai data uji, dan 80% (120 baris) sebagai data latih.random_state=42: Menyetel seed pengacakan agar hasil pembagian data bersifat deterministik dan dapat direplikasi (reproducible).stratify=y: Memastikan proporsi kelas target pada data latih dan data uji tetap seimbang (sangat krusial untuk kasus klasifikasi).
from sklearn.model_selection import train_test_split

# Membagi dataset menjadi 80% latih dan 20% uji
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

print(f"Jumlah sampel latih (X_train): {len(X_train)}")
print(f"Jumlah sampel uji   (X_test) : {len(X_test)}")
Output:
Jumlah sampel latih (X_train): 120
Jumlah sampel uji   (X_test) : 30
3. Pola Perancangan API Scikit-Learn (4 Langkah Emas)
Seluruh model di Scikit-Learn (baik Regresi Linier, Pohon Keputusan, SVM, maupun Naive Bayes) menerapkan 4 langkah alur kerja yang seragam:
Langkah A: Impor dan Instansiasi Estimator
Pilihlah kelas algoritma yang ingin digunakan, lalu inisialisasi objek model dengan hiperparameter yang diinginkan. Dalam contoh ini, kita menggunakan algoritma tetangga terdekat: K-Nearest Neighbors (KNN).
from sklearn.neighbors import KNeighborsClassifier

# Instansiasi estimator dengan parameter k=3 tetangga terdekat
model_knn = KNeighborsClassifier(n_neighbors=3)
Langkah B: Pelatihan Model Menggunakan .fit()
Metode .fit() memerintahkan model untuk mempelajari keterkaitan matematis antara data latih () dan label jawabannya ().
# Model mempelajari pola dari data latih
model_knn.fit(X_train, y_train)
print("Status model:", model_knn)
Output:
Status model: KNeighborsClassifier(n_neighbors=3)
Langkah C: Melakukan Inferensi / Prediksi dengan .predict()
Setelah model selesai dilatih, kita menguji kepintarannya dengan meminta model menebak label target dari data uji () yang belum pernah dilihat sebelumnya. Catatan penting: jangan pernah memasukkan ke dalam fungsi predict().
# Memprediksi label target untuk data uji
y_pred = model_knn.predict(X_test)

print("=== 10 Prediksi Pertama vs Jawaban Asli ===")
print("Prediksi model :", y_pred[:10])
print("Kunci asli     :", y_test.values[:10])
Output:
=== 10 Prediksi Pertama vs Jawaban Asli ===
Prediksi model : [0 2 1 1 0 1 0 0 2 1]
Kunci asli     : [0 2 1 1 0 1 0 0 2 1]
Langkah D: Mengevaluasi Skor Performa dengan .score()
Metode .score() menghitung metrik performa bawaan model. Untuk klasifikasi, metode ini mengembalikan tingkat akurasi (proporsi tebakan yang benar terhadap total sampel).
# Menghitung akurasi pada data latih dan data uji
akurasi_latih = model_knn.score(X_train, y_train)
akurasi_uji   = model_knn.score(X_test, y_test)

print(f"Akurasi pada data latih: {akurasi_latih * 100:.2f}%")
print(f"Akurasi pada data uji  : {akurasi_uji * 100:.2f}%")
Output:
Akurasi pada data latih: 95.83%
Akurasi pada data uji  : 96.67%
Akurasi sebesar 96.67% pada data uji mengindikasikan bahwa model KNN mampu menggeneralisasi pola ukuran kelopak bunga untuk mengenali spesies tanaman baru dengan tingkat keandalan yang sangat tinggi.
Coba sendiri
Buka notebook Google Colab kamu dan lakukan eksplorasi modifikasi berikut:
- Ubah hiperparameter
n_neighborspada inisialisasiKNeighborsClassifiermenjadi nilai yang berbeda: cobalah , , dan . - Amati bagaimana perubahan nilai tetangga mempengaruhi skor akurasi pada data latih vs data uji.
- Hapus parameter
stratify=ypadatrain_test_split, lalu periksa distribusi frekuensi kelas paday_testdengan perintahy_test.value_counts(). Apa perbedaan yang kamu amati?
Kesalahan yang sering terjadi
Berikut beberapa kesalahan mendasar yang sering dilakukan pemula saat mengawali pemodelan Machine Learning:
| Kesalahan Pemula | Dampak Fatal | Solusi Benar |
|---|---|---|
Melakukan evaluasi model pada data latih saja (X_train). |
Model tampak sangat pintar (akurasi 100%), namun gagal total saat diproduksi (Overfitting yang tak terdeteksi). | Selalu evaluasi model menggunakan data uji independen (X_test, y_test) yang terisolasi sejak awal. |
| Memasukkan label target ke dalam matriks fitur . | Terjadi kebocoran target (Target Leakage). Model memprediksi berdasarkan itu sendiri. | Pastikan kolom target sudah dihapus dari menggunakan df.drop(columns=['target']). |
Melewatkan parameter random_state. |
Pembagian data berubah setiap kali kode dijalankan, sehingga hasil evaluasi tidak konsisten dan sulit didebug. | Tentukan integer tetap pada random_state (misalnya random_state=42) demi reproduksibilitas eksperimen. |
Menjalankan .fit() pada data uji (X_test). |
Terjadi kebocoran data (Data Leakage), merusak validitas metodologi saintifik pengujian. | Model hanya boleh memanggil .fit() satu kali pada X_train. Untuk data uji, panggil .predict(X_test). |
| Dimensi fitur berupa array 1 dimensi (bukan matriks 2D). | Scikit-Learn memunculkan ValueError: Expected 2D array, got 1D array instead. |
Pastikan berupa DataFrame atau panggil .reshape(-1, 1) jika fitur hanya terdiri dari satu kolom. |
Kaitannya dengan Praktik Industri / AI: Pola desain API Scikit-Learn (
fit,predict,transform) telah menjadi standar arsitektur industri komputasi AI global. Bahkan ekosistem Deep Learning modern seperti PyTorch Lightning, TensorFlow Keras, Hugging Face Transformers, dan XGBoost mengadopsi konvensi penamaan metode yang serupa. Di perusahaan teknologi terkemuka, pipeline ML otomatis (AutoML) dan sistem MLOps (Machine Learning Operations) memanfaatkan konsistensi API ini untuk mengotomatisasi pengujian puluhan algoritma berbeda dalam satu baris perulangan terpadu.
Latihan
Uji pemahaman alur kerja Machine Learning kamu dengan mengerjakan 3 soal latihan terarah berikut:
- Latihan 1: Buatlah dataset sintetis regresi menggunakan fungsi bawaan
sklearn.datasets.make_regressiondengan parametern_samples=200,n_features=5,noise=15, danrandom_state=10. Pisahkan menjadi data latih dan data uji dengan proporsi 75:25! - Latihan 2: Menggunakan data latih dari Latihan 1, latihlah model regresi linier sederhana menggunakan kelas
LinearRegressiondarisklearn.linear_model. Tampilkan koefisien bobot tiap fitur (model.coef_) dan nilai intersepnya (model.intercept_)! - Latihan 3: Lakukan inferensi prediksi pada data uji (
X_test), lalu hitung skor koefisien determinasi () menggunakan metode.score(X_test, y_test). Jelaskan secara singkat interpretasi dari nilai skor tersebut!
Kunci jawaban dan pembahasan
Berikut solusi kode lengkap untuk mengonfirmasi hasil latihan mandiri kamu:
Solusi Latihan 1: Pembuatan Dataset Regresi dan Pemisahan Data
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split

# 1. Menghasilkan dataset sintetis regresi
X_reg, y_reg = make_regression(
    n_samples=200,
    n_features=5,
    noise=15.0,
    random_state=10
)

# 2. Membagi menjadi 75% data latih dan 25% data uji
X_train_reg, X_test_reg, y_train_reg, y_test_reg = train_test_split(
    X_reg, y_reg,
    test_size=0.25,
    random_state=10
)

print(f"Dimensi X_train: {X_train_reg.shape}, y_train: {y_train_reg.shape}")
print(f"Dimensi X_test : {X_test_reg.shape}, y_test : {y_test_reg.shape}")
Pembahasan:
Fungsi make_regression menghasilkan matriks fitur berukuran dan vektor target kontinu . Parameter test_size=0.25 membagi secara proporsional: 150 sampel untuk data latih dan 50 sampel untuk pengujian keandalan model.
Solusi Latihan 2: Pelatihan Model Regresi Linier dan Inspeksi Parameter
from sklearn.linear_model import LinearRegression

# 1. Instansiasi model
regresor = LinearRegression()

# 2. Pelatihan pada data latih
regresor.fit(X_train_reg, y_train_reg)

# 3. Menampilkan parameter matematis yang dipelajari
print("=== Parameter Matematis yang Dipelajari Model ===")
print("Koefisien Kemiringan (Weights / Slopes):")
for i, coef in enumerate(regresor.coef_):
    print(f"  Fitur {i+1}: {coef:.3f}")
print(f"Intersep Garis (Bias / Intercept): {regresor.intercept_:.3f}")
Pembahasan:
Saat metode .fit() dieksekusi, Scikit-Learn menghitung solusi persamaan analitik kuadrat terkecil (Ordinary Least Squares). Koefisien bobot menunjukkan seberapa besar kontribusi kenaikan 1 satuan nilai fitur terhadap perubahan nilai target .
Solusi Latihan 3: Inferensi dan Evaluasi Skor Determinasi ()
# 1. Memprediksi data uji
prediksi_regresi = regresor.predict(X_test_reg)

# 2. Mengukur skor koefisien determinasi R^2
skor_r2 = regresor.score(X_test_reg, y_test_reg)

print(f"Skor Koefisien Determinasi R^2 pada Data Uji: {skor_r2:.4f}")
print(f"Persentase variansi yang mampu dijelaskan: {skor_r2 * 100:.2f}%")
Pembahasan:
Pada model regresi di Scikit-Learn, metode .score(X_test, y_test) menghitung nilai koefisien determinasi . Nilai mengukur proporsi variabilitas variabel target yang mampu diprediksi secara akurat oleh fitur-fitur independen. Nilai mendekati 1.0 (misalnya ) menandakan model memiliki kemampuan prediksi yang sangat presisi terhadap data baru.


Diskusi (0)
Kami menyimpan nama (opsional), komentar, dan hash teknis (bukan alamat IP asli) untuk mencegah spam. Cookie fungsional dipakai agar Anda dapat mengedit atau menghapus komentar sendiri dari browser ini. Untuk permintaan penghapusan, gunakan halaman kontak.
Belum ada komentar. Mulai diskusinya.