Data Science
Model Regresi: Memprediksi Nilai Kontinu
Pelajari cara membangun model regresi linier dengan Scikit-Learn untuk memprediksi nilai kontinu, memahami garis best-fit, serta mengukur akurasi galat menggunakan MAE, RMSE, dan R-squared.
Bayangkan sebuah perusahaan teknologi properti ingin meluncurkan fitur estimasi harga jual rumah secara instan di platform digitalnya. Calon penjual memasukkan data spesifikasi hunian seperti luas tanah, luas bangunan, jumlah kamar tidur, dan jarak ke stasiun terdekat. Jika estimasi harga ditentukan secara manual berdasarkan intuisi agen semata, kalkulasi tersebut rentan bias pribadi, memakan waktu lama, dan sulit diandalkan dalam skala ribuan transaksi per hari. Harga yang ditetapkan terlalu mahal akan membuat properti mangkal berbulan-bulan tanpa pembeli, sedangkan taksiran yang terlampau murah tentu merugikan pemilik hunian. Dalam machine learning, tantangan memprediksi angka kontinu—seperti harga rumah, suhu harian, estimasi waktu tempuh logistik, atau proyeksi laba kuartalan—diselesaikan melalui kelompok pemodelan yang disebut Regresi (Regression).
Yang akan dipelajari
Dalam artikel ini, Anda akan mempelajari fondasi matematika dan praktik implementasi model regresi:
- Memahami konsep dasar Regresi Linier dan intuisi pencarian garis terbaik (best fit line).
- Menyiapkan variabel fitur dua dimensi () dan vektor target () sesuai konvensi Scikit-Learn.
- Melatih model
LinearRegressionmenggunakan metode.fit()dan menghasilkan estimasi dengan.predict(). - Menginterpretasikan koefisien kemiringan (slope/weight) dan nilai perpotongan sumbu (intercept/bias).
- Melakukan evaluasi performa model regresi menggunakan metrik MAE, MSE, RMSE, dan koefisien determinasi ().
- Menerapkan Regresi Linier Berganda (Multiple Linear Regression) dengan banyak variabel prediktor sekaligus.
Intuisi Dasar Regresi Linier
Regresi Linier (Linear Regression) adalah algoritma supervised learning yang memodelkan hubungan linear antara satu atau beberapa variabel independen (fitur ) dengan satu variabel dependen kontinu (target ).
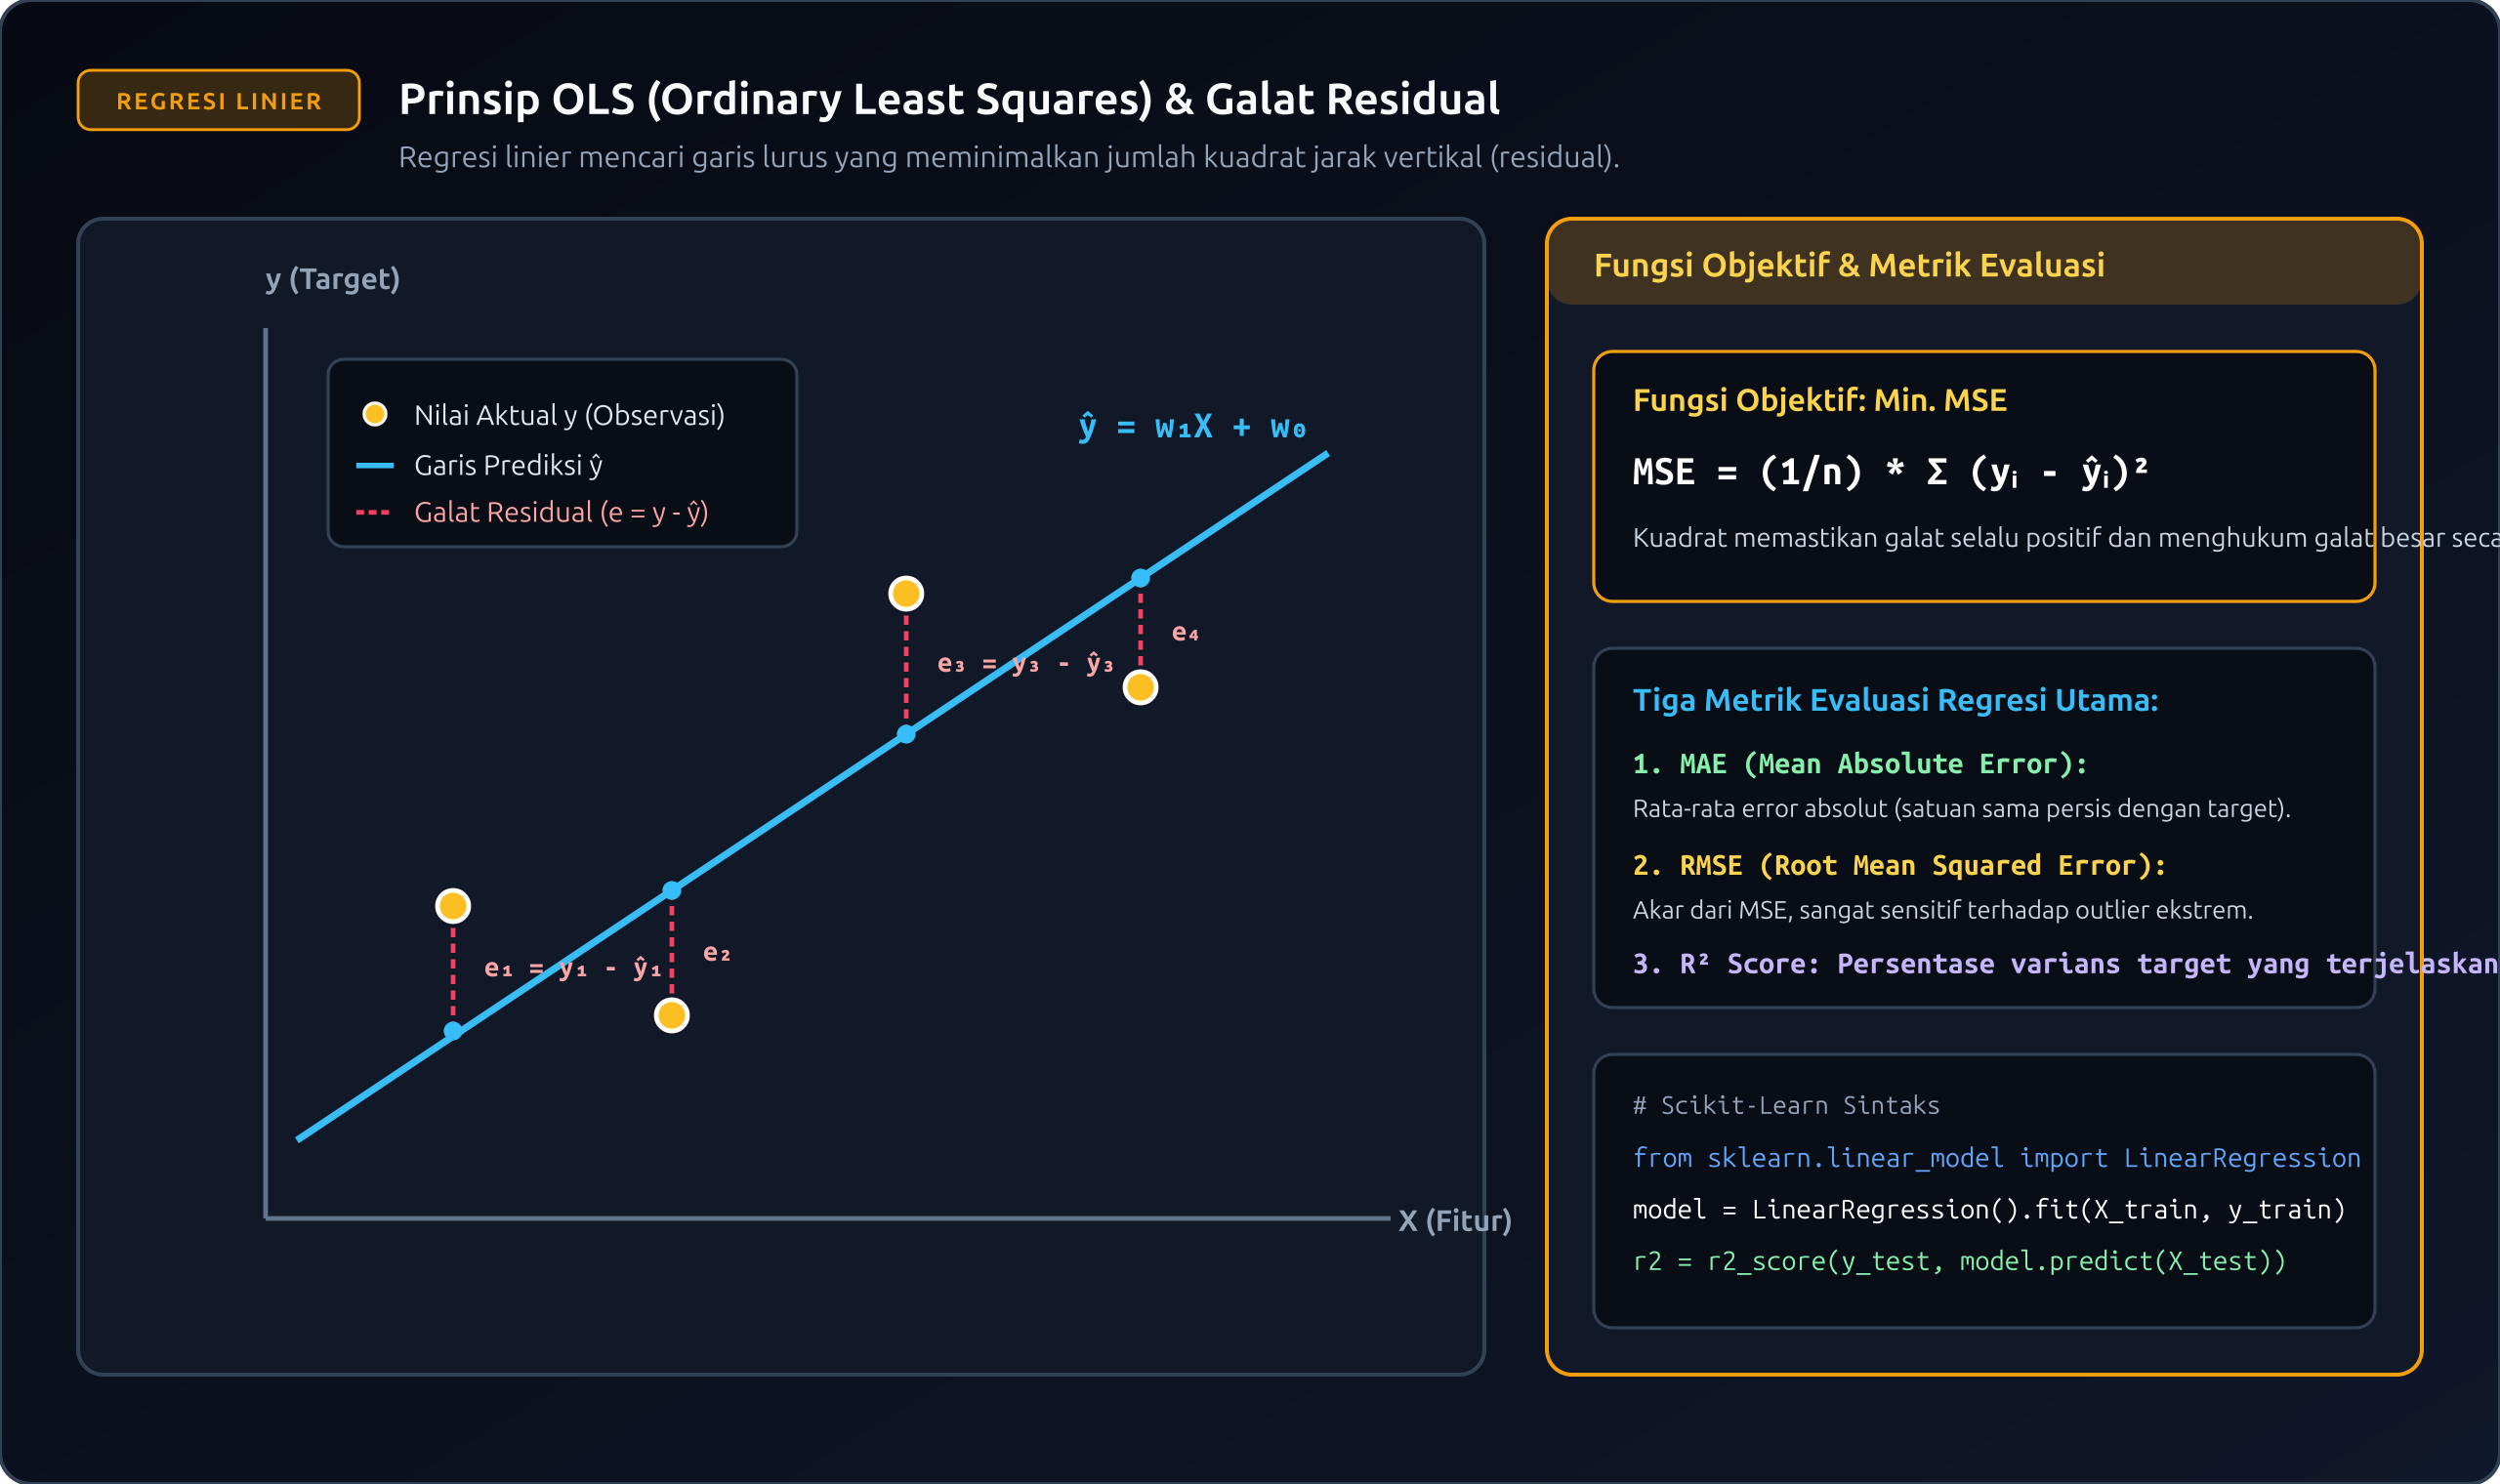
Pada kasus paling sederhana dengan satu fitur (Simple Linear Regression), relasi tersebut dimodelkan dalam persamaan garis lurus klasik:
Di mana:
- adalah nilai target yang diprediksi (misalnya: harga rumah).
- adalah nilai fitur input (misalnya: luas bangunan dalam meter persegi).
- (weight atau slope) menyatakan koefisien kemiringan. Nilai ini menunjukkan seberapa besar perubahan nilai untuk setiap peningkatan satu satuan nilai .
- (bias atau intercept) menyatakan titik potong garis pada sumbu ketika nilai .
Bagaimana algoritma menemukan nilai dan yang paling tepat? Scikit-Learn menggunakan pendekatan optimasi matematika bernama Ordinary Least Squares (OLS). OLS menghitung selisih vertikal antara titik data aktual () dengan titik garis estimasi (), yang disebut sebagai nilai sisaan (residual). Algoritma kemudian mencari pasangan nilai dan sedemikian rupa sehingga jumlah kuadrat dari seluruh residual tersebut bernilai paling minimal.
Membangun Model Regresi Sederhana dengan Scikit-Learn
Mari kita simulasikan kasus penaksiran harga sewa apartemen bulanan (dalam juta rupiah) berdasarkan luas unit bangunan (dalam meter persegi) menggunakan Scikit-Learn dan Pandas.
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

# 1. Menyiapkan dataset sintetis
np.random.seed(42)
luas_m2 = np.array([21, 28, 36, 45, 50, 60, 68, 75, 84, 95, 105, 120])
# Harga sewa bulanan (juta rupiah) dengan sedikit derau acak
harga_sewa = 1.5 + (0.08 * luas_m2) + np.random.normal(0, 0.35, size=len(luas_m2))

df = pd.DataFrame({
    "luas_m2": luas_m2,
    "harga_juta": np.round(harga_sewa, 2)
})

print("Contoh 5 data pertama:")
print(df.head())

# 2. Memisahkan Fitur (X) dan Target (y)
# Catatan penting: Scikit-Learn mewajibkan X berupa matriks 2D
X = df[["luas_m2"]]  # DataFrame 2 dimensi (n_samples, n_features)
y = df["harga_juta"] # Series 1 dimensi (n_samples,)

# 3. Membagi data latih (80%) dan data uji (20%)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42
)

# 4. Inisialisasi dan pelatihan model
model_regresi = LinearRegression()
model_regresi.fit(X_train, y_train)

# 5. Memeriksa parameter yang dipelajari model
slope = model_regresi.coef_[0]
intercept = model_regresi.intercept_

print(f"\nPersamaan garis: Harga = {slope:.4f} * Luas + {intercept:.4f}")

# Output:
# Contoh 5 data pertama:
#    luas_m2  harga_juta
# 0       21        3.35
# 1       28        3.69
# 2       36        4.62
# 3       45        5.63
# 4       50        5.43
#
# Persamaan garis: Harga = 0.0768 * Luas + 1.7058
Dari hasil pelatihan di atas, model menghasilkan kemiringan dan perpotongan . Interpretasi bisnisnya sangat lugas: setiap penambahan luas unit sebesar , estimasi harga sewa diproyeksikan naik rata-rata sebesar 0,0768 juta rupiah (sekitar Rp76.800), dengan harga dasar (base cost) sebesar Rp1.705.800.
Melakukan Inferensi dan Evaluasi Galat Prediksi
Setelah model selesai dilatih, langkah krusial berikutnya adalah menguji keandalannya pada data baru (test set) yang belum pernah dilihat oleh model saat proses pelatihan. Kita menggunakan metode .predict() untuk menghasilkan nilai taksiran.
# Menghitung prediksi pada data uji
y_pred = model_regresi.predict(X_test)

hasil_komparasi = pd.DataFrame({
    "Luas (m2)": X_test["luas_m2"].values,
    "Harga Aktual (Juta)": y_test.values,
    "Harga Prediksi (Juta)": np.round(y_pred, 2),
    "Selisih / Error": np.round(np.abs(y_test.values - y_pred), 2)
})

print(hasil_komparasi)

# Output:
#    Luas (m2)  Harga Aktual (Juta)  Harga Prediksi (Juta)  Selisih / Error
# 0        120                11.13                  10.92             0.21
# 1         95                 8.97                   9.00             0.03
# 2         45                 5.63                   5.16             0.47
Dalam memprediksi nilai kontinu, prediksi model hampir tidak pernah tepat 100% pada angka desimal yang persis. Oleh karena itu, kita tidak bisa memakai metrik "Akurasi persentase" seperti pada klasifikasi. Kita membutuhkan metrik evaluasi regresi formal:
1. Mean Absolute Error (MAE)
MAE menghitung rata-rata dari selisih mutlak (nilai absolut) antara target aktual () dan target prediksi ():
Kelebihan utama MAE adalah satuannya sama persis dengan satuan target aslinya (juta rupiah) dan bersifat intuitif untuk dipresentasikan ke tim non-teknis.
2. Mean Squared Error (MSE)
MSE menghitung rata-rata kuadrat selisih antara nilai aktual dan prediksi:
Karena selisih dikuadratkan, nilai galat yang besar (outlier) akan menerima hukuman (penalty) yang jauh lebih berat.
3. Root Mean Squared Error (RMSE)
RMSE adalah akar kuadrat dari nilai MSE:
RMSE menggabungkan keunggulan MSE yang sensitif terhadap kesalahan fatal dengan satuan pengukuran yang kembali setara dengan variabel target.
4. R-squared ( Score)
Koefisien determinasi mengukur seberapa besar proporsi varians variabel target yang sukses dijelaskan oleh fitur-fitur pada model:
Nilai ideal berkisar antara 0.0 hingga 1.0. Nilai menandakan model mampu memprediksi variasi target secara sempurna, sedangkan nilai mendekati menandakan model tidak lebih baik daripada sekadar menebak rata-rata target.
Mari kita hitung seluruh metrik tersebut dengan modul sklearn.metrics:
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

mae = mean_absolute_error(y_test, y_pred)
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
r2 = r2_score(y_test, y_pred)

print(f"Evaluasi Model pada Data Uji:")
print(f"- MAE  : {mae:.3f} juta rupiah")
print(f"- MSE  : {mse:.3f}")
print(f"- RMSE : {rmse:.3f} juta rupiah")
print(f"- R2   : {r2:.4f}")

# Output:
# Evaluasi Model pada Data Uji:
# - MAE  : 0.237 juta rupiah
# - MSE  : 0.089
# - RMSE : 0.298 juta rupiah
# - R2   : 0.9852
Nilai sebesar menunjukkan bahwa sebesar 98,5% variasi harga sewa dapat dijelaskan secara linier oleh faktor luas bangunan. Galat rata-rata (RMSE) berada di angka 0.298 juta rupiah (sekitar Rp298.000).
Regresi Linier Berganda (Multiple Linear Regression)
Di dunia nyata, satu fenomena jarang sekali hanya dipengaruhi oleh satu variabel tunggal. Harga sewa rumah tidak cuma bergantung pada luas lantai, tetapi juga umur bangunan dan jumlah kamar tidur:
Scikit-Learn menangani regresi berganda secara mulus tanpa perubahan sintaks pemanggilan:
# Menambahkan fitur umur bangunan (tahun) dan jumlah kamar
data_rumah = pd.DataFrame({
    "luas_m2": [36, 45, 54, 70, 90, 120, 150, 60, 80, 110],
    "umur_tahun": [2, 5, 8, 3, 12, 1, 6, 15, 4, 7],
    "kamar_tidur": [1, 2, 2, 3, 3, 4, 5, 2, 3, 4],
    "harga_juta": [4.2, 5.5, 6.0, 7.8, 8.5, 12.0, 14.5, 5.8, 8.9, 11.2]
})

# Matriks fitur X dengan 3 kolom
X_multi = data_rumah[["luas_m2", "umur_tahun", "kamar_tidur"]]
y_multi = data_rumah["harga_juta"]

model_multi = LinearRegression()
model_multi.fit(X_multi, y_multi)

print("Koefisien masing-masing fitur:")
for kolom, bobot in zip(X_multi.columns, model_multi.coef_):
    print(f"- {kolom:12s}: {bobot:+.4f}")
print(f"Intercept   : {model_multi.intercept_:.4f}")

# Output:
# Koefisien masing-masing fitur:
# - luas_m2     : +0.0762
# - umur_tahun  : -0.0934
# - kamar_tidur : +0.4150
# Intercept   : 1.0821
Perhatikan tanda positif dan negatif koefisien di atas:
luas_m2bernilai positif (): makin luas, makin mahal.umur_tahunbernilai negatif (): makin tua usia bangunan, nilai sewanya mengalami depresiasi sekitar Rp93.400 per tahun.kamar_tidurbernilai positif (): setiap kamar tambahan meningkatkan sewa sekitar Rp415.000.
Coba sendiri
Jalankan eksperimen interaktif berikut di lingkungan Google Colab Anda:
- Buat notebook baru dan salin kode pembuatan
data_rumahdi atas. - Prediksikan harga sewa unit apartemen baru yang memiliki spesifikasi:
luas_m2 = 65,umur_tahun = 2, dankamar_tidur = 2. - Gunakan sintaks
model_multi.predict([[65, 2, 2]])dan cetak hasil estimasi nominalnya. - Ubah nilai
umur_tahunmenjadi 20 tahun, lalu perhatikan bagaimana proyeksi harganya menurun akibat koefisien negatif umur bangunan.
# Coba jalankan di sel Colab:
unit_baru = pd.DataFrame([{
    "luas_m2": 65,
    "umur_tahun": 2,
    "kamar_tidur": 2
}])

estimasi = model_multi.predict(unit_baru)
print(f"Estimasi sewa unit baru: Rp{estimasi[0]:.2f} juta/bulan")
Kesalahan yang sering terjadi
Berikut adalah kompilasi kesalahan umum saat melatih model regresi beserta penanganannya:
| Kesalahan Pemula | Gejala / Pesan Kesalahan | Penyebab Utama | Solusi yang Tepat |
|---|---|---|---|
| Memasukkan fitur berupa array 1 dimensi | ValueError: Expected 2D array, got 1D array instead |
Memilih kolom dengan tanda kurung siku tunggal df['luas'] alih-alih kurung siku ganda. |
Gunakan kurung siku ganda df[['luas']] agar Scikit-Learn menerima matriks berdimensi (n_samples, 1). |
| Menghitung metrik evaluasi pada data latih | Nilai RMSE tampak sangat kecil, namun saat diuji di produksi prediksi meleset jauh | Terjebak evaluasi data latih (training performance) tanpa memisahkan data uji (test set). | Selalu hitung MAE/RMSE pada X_test dan y_test hasil train_test_split(). |
| Mengira skor pasti berada di rentang 0 hingga 1 | Nilai bertanda negatif (misal: -0.42) |
Model yang dilatih sangat buruk dan performa prediksinya lebih rendah dibanding garis rata-rata horizontal. | Periksa kualitas data, tangani outlier ekstrem, atau tambahkan variabel fitur yang relevan. |
| Memasukkan kolom teks tanpa konversi | ValueError: could not convert string to float |
Mencoba memasukkan kolom kategori string langsung ke dalam LinearRegression. |
Ubah kolom teks ke format numerik melalui teknik encoding sebelum memanggil .fit(). |
Kaitannya dengan Praktik Industri / AI: Dalam arsitektur sistem berbasis kecerdasan buatan, model Regresi Linier sering kali dijadikan baseline benchmark pertama. Sebelum seorang data scientist menerapkan model kompleks seperti XGBoost, Random Forest, atau Deep Neural Network, mereka wajib membandingkan hasilnya dengan regresi linier sederhana. Jika model deep learning dengan ratusan ribu parameter hanya mampu menurunkan RMSE sebesar 0,5% dibandingkan regresi linier berbiaya komputasi rendah, industri lebih memilih mengoperasikan regresi linier karena lebih cepat, hemat server, dan transparan untuk diaudit oleh regulator kepatuhan bisnis.
Latihan
Ujilah pemahaman Anda tentang pemodelan regresi dengan menyelesaikan 3 latihan analisis mandiri berikut:
- Soal 1: Sebuah tim logistik mengukur waktu tempuh pengiriman barang aktual vs estimasi sistem navigasi pada 4 rute (dalam menit): aktual =
[25, 40, 18, 55], prediksi =[28, 36, 22, 50]. Buat fungsi manual (atau gunakan Scikit-Learn) untuk menghitung nilai MAE dan RMSE dari keempat rute tersebut. - Soal 2: Diberikan data lama belajar siswa per minggu (jam) =
[2, 4, 6, 8, 10, 12]dan nilai ujian akhir =[50, 58, 67, 76, 84, 95]. Latih modelLinearRegressionsederhana, lalu cetak nilai kemiringan garis (slope) dan nilai perpotongan sumbu (intercept). - Soal 3: Berdasarkan model dari Soal 2, hitung prediksi nilai ujian jika seorang siswa belajar selama 7 jam. Kemudian hitung nilai score dari model tersebut terhadap data latihnya untuk mengetahui seberapa kuat korelasi linier jam belajar terhadap capaian nilai.
Kunci jawaban dan pembahasan
Solusi Soal 1
import numpy as np
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Data waktu tempuh logistik (menit)
y_aktual = np.array([25, 40, 18, 55])
y_prediksi = np.array([28, 36, 22, 50])

# Menghitung MAE dan RMSE
mae = mean_absolute_error(y_aktual, y_prediksi)
mse = mean_squared_error(y_aktual, y_prediksi)
rmse = np.sqrt(mse)

print(f"MAE  : {mae:.2f} menit")
print(f"RMSE : {rmse:.2f} menit")

# Output:
# MAE  : 4.00 menit
# RMSE : 4.12 menit
Pembahasan: Nilai selisih absolut tiap rute adalah , , , dan . Rata-rata selisih absolutnya adalah menit. Sementara nilai kuadrat selisihnya adalah , sehingga menit.
Solusi Soal 2
import numpy as np
from sklearn.linear_model import LinearRegression

# Menyiapkan fitur X (matriks 2D) dan target y
jam_belajar = np.array([2, 4, 6, 8, 10, 12]).reshape(-1, 1)
nilai_ujian = np.array([50, 58, 67, 76, 84, 95])

# Inisialisasi dan pelatihan model
model_belajar = LinearRegression()
model_belajar.fit(jam_belajar, nilai_ujian)

print(f"Slope (w)     : {model_belajar.coef_[0]:.4f}")
print(f"Intercept (b) : {model_belajar.intercept_:.4f}")

# Output:
# Slope (w)     : 4.3857
# Intercept (b) : 41.0000
Pembahasan: Nilai slope mengindikasikan bahwa setiap penambahan 1 jam durasi belajar per minggu berkontribusi menaikkan nilai ujian sekitar 4,39 poin. Nilai intercept mencerminkan nilai perkiraan dasar siswa jika jam belajar bernilai 0 jam.
Solusi Soal 3
from sklearn.metrics import r2_score

# 1. Prediksi untuk 7 jam belajar
jam_baru = np.array([[7]])
prediksi_nilai = model_belajar.predict(jam_baru)

# 2. Menghitung R2 score pada keseluruhan data latih
prediksi_semua = model_belajar.predict(jam_belajar)
skor_r2 = r2_score(nilai_ujian, prediksi_semua)

print(f"Prediksi nilai untuk 7 jam belajar: {prediksi_nilai[0]:.2f}")
print(f"Skor R-squared (R2)                 : {skor_r2:.4f}")

# Output:
# Prediksi nilai untuk 7 jam belajar: 71.70
# Skor R-squared (R2)                 : 0.9959
Pembahasan: Dengan mensubstitusikan ke dalam persamaan garis , diperoleh nilai taksiran . Skor sebesar mengonfirmasi bahwa variasi nilai ujian siswa dijelaskan secara nyaris sempurna (99,59%) oleh faktor durasi jam belajar.


Diskusi (0)
Kami menyimpan nama (opsional), komentar, dan hash teknis (bukan alamat IP asli) untuk mencegah spam. Cookie fungsional dipakai agar Anda dapat mengedit atau menghapus komentar sendiri dari browser ini. Untuk permintaan penghapusan, gunakan halaman kontak.
Belum ada komentar. Mulai diskusinya.